Reflection Beam 与 Mistral Large 4 同期亮相:开放权重选项增加,但权重与许可尚未落地
Segundo o site chinês InfoQ, em outubro de 2026, entre 5 e 6 de outubro a americana Reflection lançou o Beam, seu primeiro modelo MoE de pesos abertos, e a francesa Mistral apresentou o Mistral Large 4, seu maior modelo até hoje. A reportagem afirma que a eficiência de inferência é o argumento de venda do Beam e que alguns benchmarks se aproximam do GLM-5.2, mas ficam atrás da geração mais recente chinesa; o Large 4 já tem prévia de API aberta e os pesos completos estão planejados para o fim de outubro, e nenhuma das duas versões está atualmente listada no KimiSeek.
O que mudou
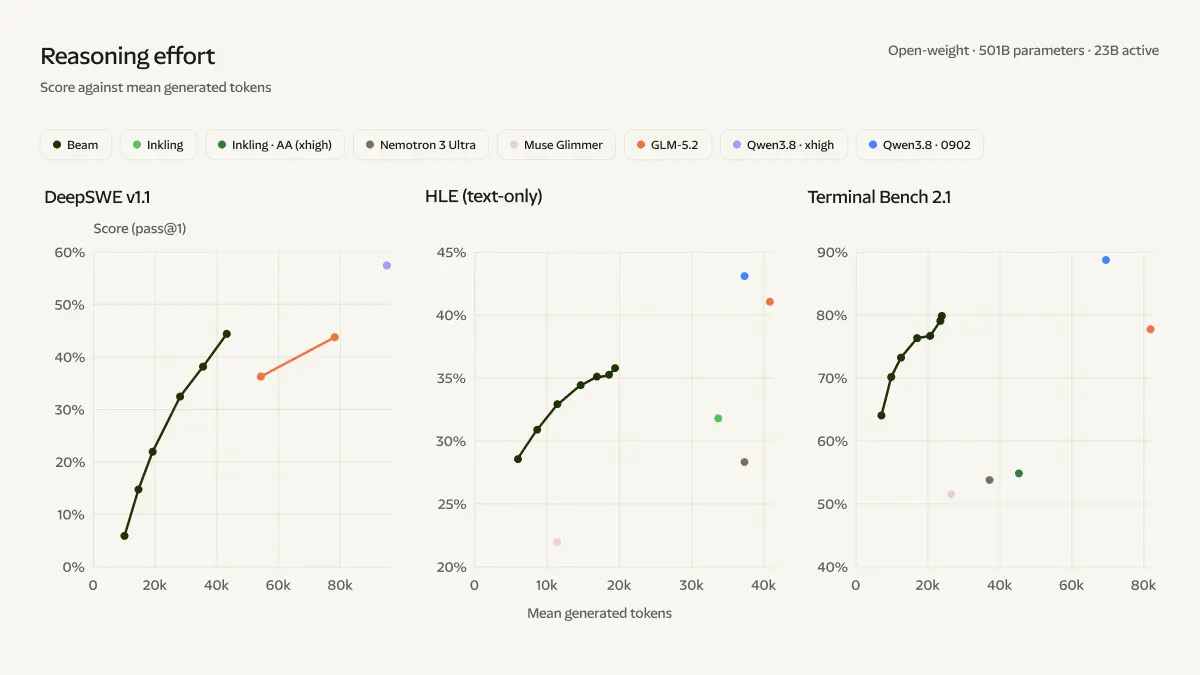
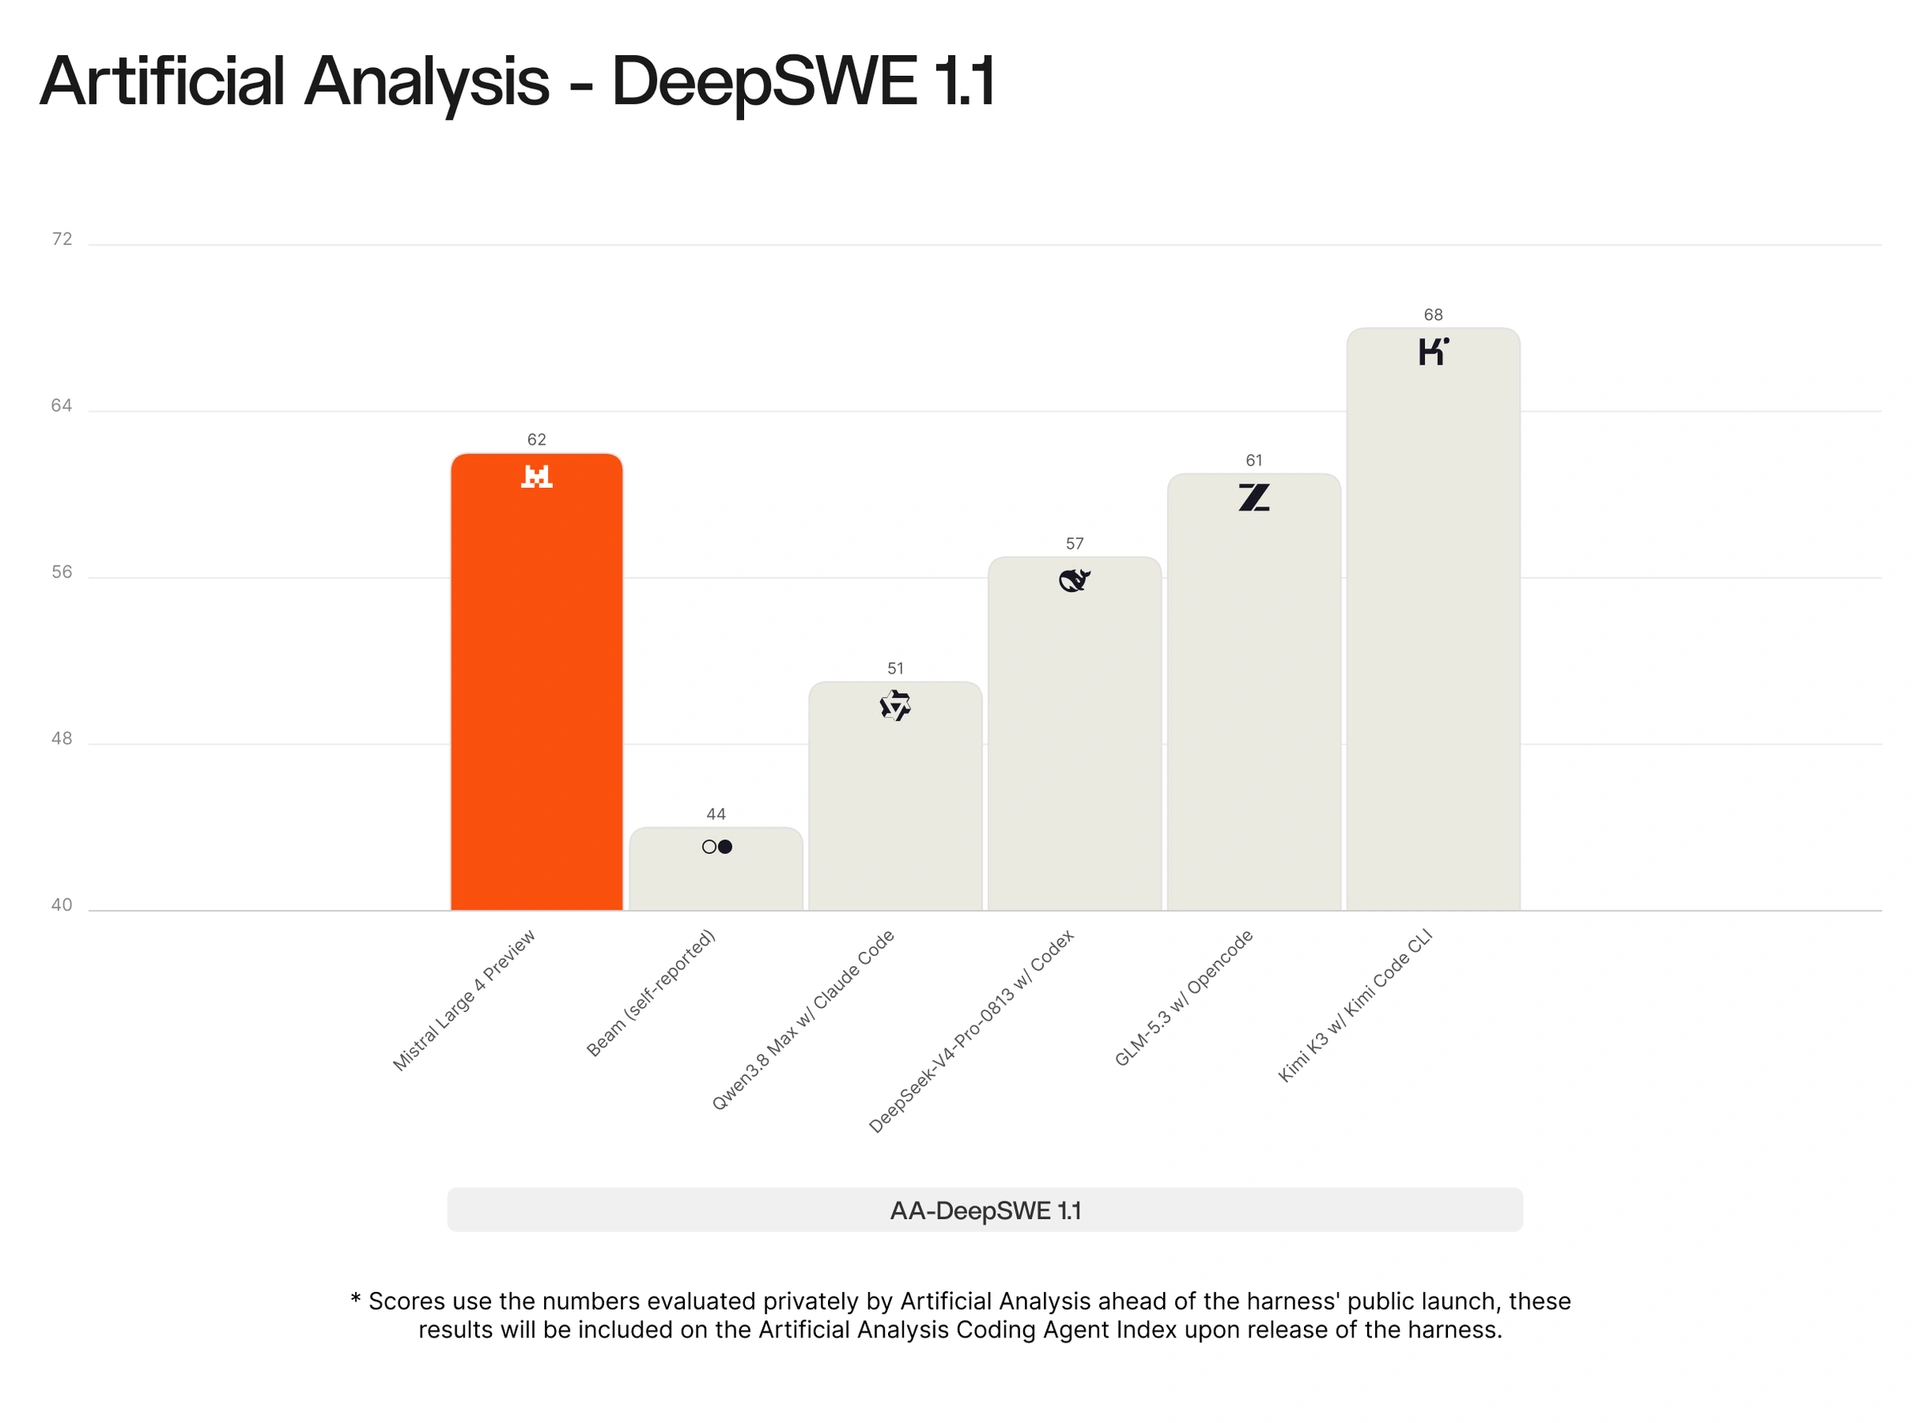
Segundo o site chinês InfoQ (o texto original indica 5 a 6 de outubro no horário local), a startup americana Reflection lançou o Beam, seu primeiro modelo de pesos abertos, e um dia depois a francesa Mistral apresentou o Mistral Large 4. A reportagem afirma que o Beam é um modelo MoE, com 501 bilhões de parâmetros totais e 23 bilhões ativados por token, voltado a programação, raciocínio e cargas de trabalho de agentes, pré-treinado com 23,8 trilhões de tokens, e que usou 10,5 mil GPUs Nvidia GB300 em quatro semanas contínuas de aprendizado por reforço de alto desempenho, gerando mais de 100 milhões de rollouts; no lançamento ainda estava na fase final de testes de red team, e a reportagem diz que a Reflection planeja publicar os pesos, o relatório técnico e as ferramentas de desenvolvimento em outubro. O Mistral Large 4, segundo a reportagem, tem 52 bilhões de parâmetros ativados e 1,05 trilhão de parâmetros totais, inclui um codificador visual de 1,6 bilhão de parâmetros, é nativamente multimodal, suporta mais de 160 idiomas e tem janela de contexto de 1 milhão de tokens; teria sido treinado do zero em data centers europeus com cerca de 3.800 GPUs Nvidia Grace Blackwell, e no momento da reportagem já tinha prévia de API aberta, com os pesos completos planejados para o fim de outubro. Nos dados de benchmark reproduzidos pela reportagem, o Beam obteve 44,4 no DeepSWE v1.1 e 80,1 no Terminal Bench v2.1, ambos abaixo dos resultados listados para GLM-5.3, Kimi K3 e DeepSeek V4.1 Flash; no Humanity's Last Exam, o Beam obteve 36,2, abaixo dos 42,3 do GLM-5.3 e dos 46,9 do Kimi K3 também listados no texto original (o texto não informa a pontuação do DeepSeek V4.1 Flash nesse item). No lado da Mistral, a reportagem afirma que o Large 4 supera o DeepSeek V4 Pro e o Qwen 3.8 Max no Coding Agent Index oficial, ficando abaixo do Kimi K3, e que no AutomationBench supera o Kimi K3, o MiMo-V2.6-Pro e o DeepSeek V4 Pro, ficando abaixo do GLM-5.3. Essas pontuações vêm de declarações dos fabricantes ou de testes de terceiros citados por eles, sendo reprodução da reportagem, sem replicação independente.
Impacto para desenvolvedores
Esse conjunto de lançamentos altera o conjunto de candidatos e as coordenadas de comparação do campo de pesos abertos, mas não muda imediatamente a disponibilidade dos modelos chineses. O ponto de maior peso para engenharia é que a Reflection deslocou o argumento de venda do Beam da capacidade absoluta para "quanta inteligência se obtém por unidade de poder de inferência"; a reportagem afirma que algumas tarefas avançadas de raciocínio podem atingir desempenho próximo ao do GLM-5.2 com cerca de um quarto a um terço do poder de computação. Se essa afirmação se confirmar em cargas próprias, o que muda é a estrutura de custo por tarefa em agentes de cadeia longa e inferência em lote. Mas, pelos benchmarks reproduzidos na reportagem, o Beam iguala principalmente a geração anterior de modelos chineses: no DeepSWE v1.1 e no Terminal Bench v2.1 fica abaixo do GLM-5.3, do Kimi K3 e do DeepSeek V4.1 Flash também listados no texto original, e no HLE fica abaixo do GLM-5.3 e do Kimi K3 ali listados; portanto, "menos computação por capacidade próxima" e "mesma computação por qualidade maior" são dois caminhos de substituição distintos e não se substituem mutuamente. O Mistral Large 4 tem outro foco: contexto de nível milionário, multimodalidade nativa e multilinguismo, somados à implantação em nuvem privada ou local e a políticas de segurança personalizadas destacadas na reportagem, apontando para fluxos de trabalho empresariais entre aplicações e cenários que exigem controle do limite dos dados, e não para uma disputa puramente de benchmarks de programação. É preciso distinguir conceitos: ambos são descritos como de pesos abertos, mas os momentos de disponibilidade dos pesos diferem na reportagem, e no lançamento nenhum dos dois tinha pesos de fato abertos; pesos abertos significam arquivos de modelo baixáveis, o que é uma questão diferente de os dados de treinamento, o código de treinamento e os termos de licença serem abertos; a reportagem não fornece detalhes de licença, e não se pode inferir direitos de uso comercial, redistribuição ou ajuste fino a partir dela. Além disso, conforme verificação no catálogo atual, nem o Beam nem o Mistral Large 4 têm entrada correspondente no KimiSeek; a prévia de API e a disponibilidade citadas na reportagem referem-se aos canais dos próprios fabricantes.
Integração e avaliação
O que segue é análise ou recomendação condicional, não fato reportado. Primeiro, se a carga principal for programação com agentes de cadeia longa e o custo for sensível: a reportagem afirma que o Beam pode se aproximar do GLM-5.2 com cerca de um quarto a um terço do poder de inferência, e as opções semelhantes disponíveis atualmente incluem o GLM-5.2 e o DeepSeek V4.1 Flash; pode-se começar com uma comparação de pequena amostra usando trajetórias próprias de chamadas de ferramentas em múltiplas rodadas, medindo "tokens totais e latência ponta a ponta por tarefa concluída", desde que se aceite que ele fica abaixo da geração mais recente chinesa nos benchmarks citados; se a taxa de falhas aumentar e disparar novas tentativas, a economia de computação será anulada, e nesse caso não convém substituir, podendo-se definir como critério de avaliação uma queda na taxa de sucesso ponta a ponta no mesmo conjunto de tarefas que não ultrapasse um limite predefinido. Segundo, se a carga exigir contexto de nível milionário, entrada multimodal ou multilinguismo: o Mistral Large 4, segundo a reportagem, suporta contexto de 1 milhão de tokens e mais de 160 idiomas, mas os pesos e os termos finais não estão definidos; convém primeiro validar, na fase de prévia de API, a precisão de recuperação em contexto longo e o desempenho do codificador visual em documentos próprios, medindo a precisão de perguntas e respostas em contexto longo e o custo por requisição, desde que não se trate o comportamento da versão de prévia como equivalente ao dos futuros pesos abertos e se mantenha o modelo principal atual como fallback. Ambas as regras devem ser revisadas uma vez mais depois que os pesos forem oficialmente publicados e a licença for esclarecida.
Limites e pontos a confirmar
O conteúdo da reportagem vem principalmente de declarações dos fabricantes e de testes de terceiros citados por eles; as pontuações de benchmark não foram replicadas de forma independente e não devem ser tratadas como conclusões verificadas. Cabe destacar em especial: no Humanity's Last Exam, o texto original fornece apenas Beam 36,2, GLM-5.3 42,3 e Kimi K3 46,9, e não lista a pontuação do DeepSeek V4.1 Flash no HLE; portanto, a comparação no HLE deve limitar-se ao GLM-5.3 e ao Kimi K3 efetivamente listados no original, e agrupar os três benchmarks como "todos abaixo dos três" é uma comparação entre benchmarks não sustentada pelo texto. Além disso, nem o Beam nem o Mistral Large 4 têm entrada correspondente no catálogo atual de modelos do KimiSeek, ou seja, essas duas versões não estão atualmente listadas no KimiSeek; a prévia de API e o plano de publicação de pesos citados na reportagem referem-se à disponibilidade nos canais dos próprios fabricantes, sem relação com o fato de o KimiSeek oferecê-los ou não. A disponibilidade de pesos não equivale a uma licença de código aberto; a reportagem não apresenta os termos de licença, e os direitos de uso comercial e redistribuição dependem da licença efetivamente publicada pelo fabricante. A reportagem afirma que os pesos do Beam estão planejados para outubro e os pesos completos do Large 4 para o fim de outubro; no lançamento, nenhum dos dois tinha pesos realmente abertos, e ainda é incerto se os prazos serão cumpridos e como os termos mudarão. A afirmação de "cerca de um quarto a um terço do poder de computação" é da própria Reflection, sem critério de medição independente, e o efeito real da substituição precisa ser validado em cargas próprias. Este resumo não julga o cumprimento de roteiros futuros nem de promessas de modelo de negócio das duas empresas.
Ilustrações da notícia original