Supersonic Labs 发布 Julia 1:1.443 亿参数 Apache 2.0 决策模型,可在 CPU 端运行
Segundo o MarkTechPost, em 26 de setembro de 2026, o laboratório brasileiro Supersonic Labs lançou o Julia 1, um modelo de decisão de 144,3 milhões de parâmetros baseado no mmBERT-small, com pesos liberados sob Apache 2.0, suporte a três tipos de chamada (choice, score, noul) e execução local em CPU. Seus experimentos superaram os valores de referência do Jev em Typed Decisions, AG News e DAIR Emotion, mas ficaram claramente atrás no Banking77 com 72 rótulos; a API hospedada foi anunciada, mas ainda não está disponível.

O que mudou
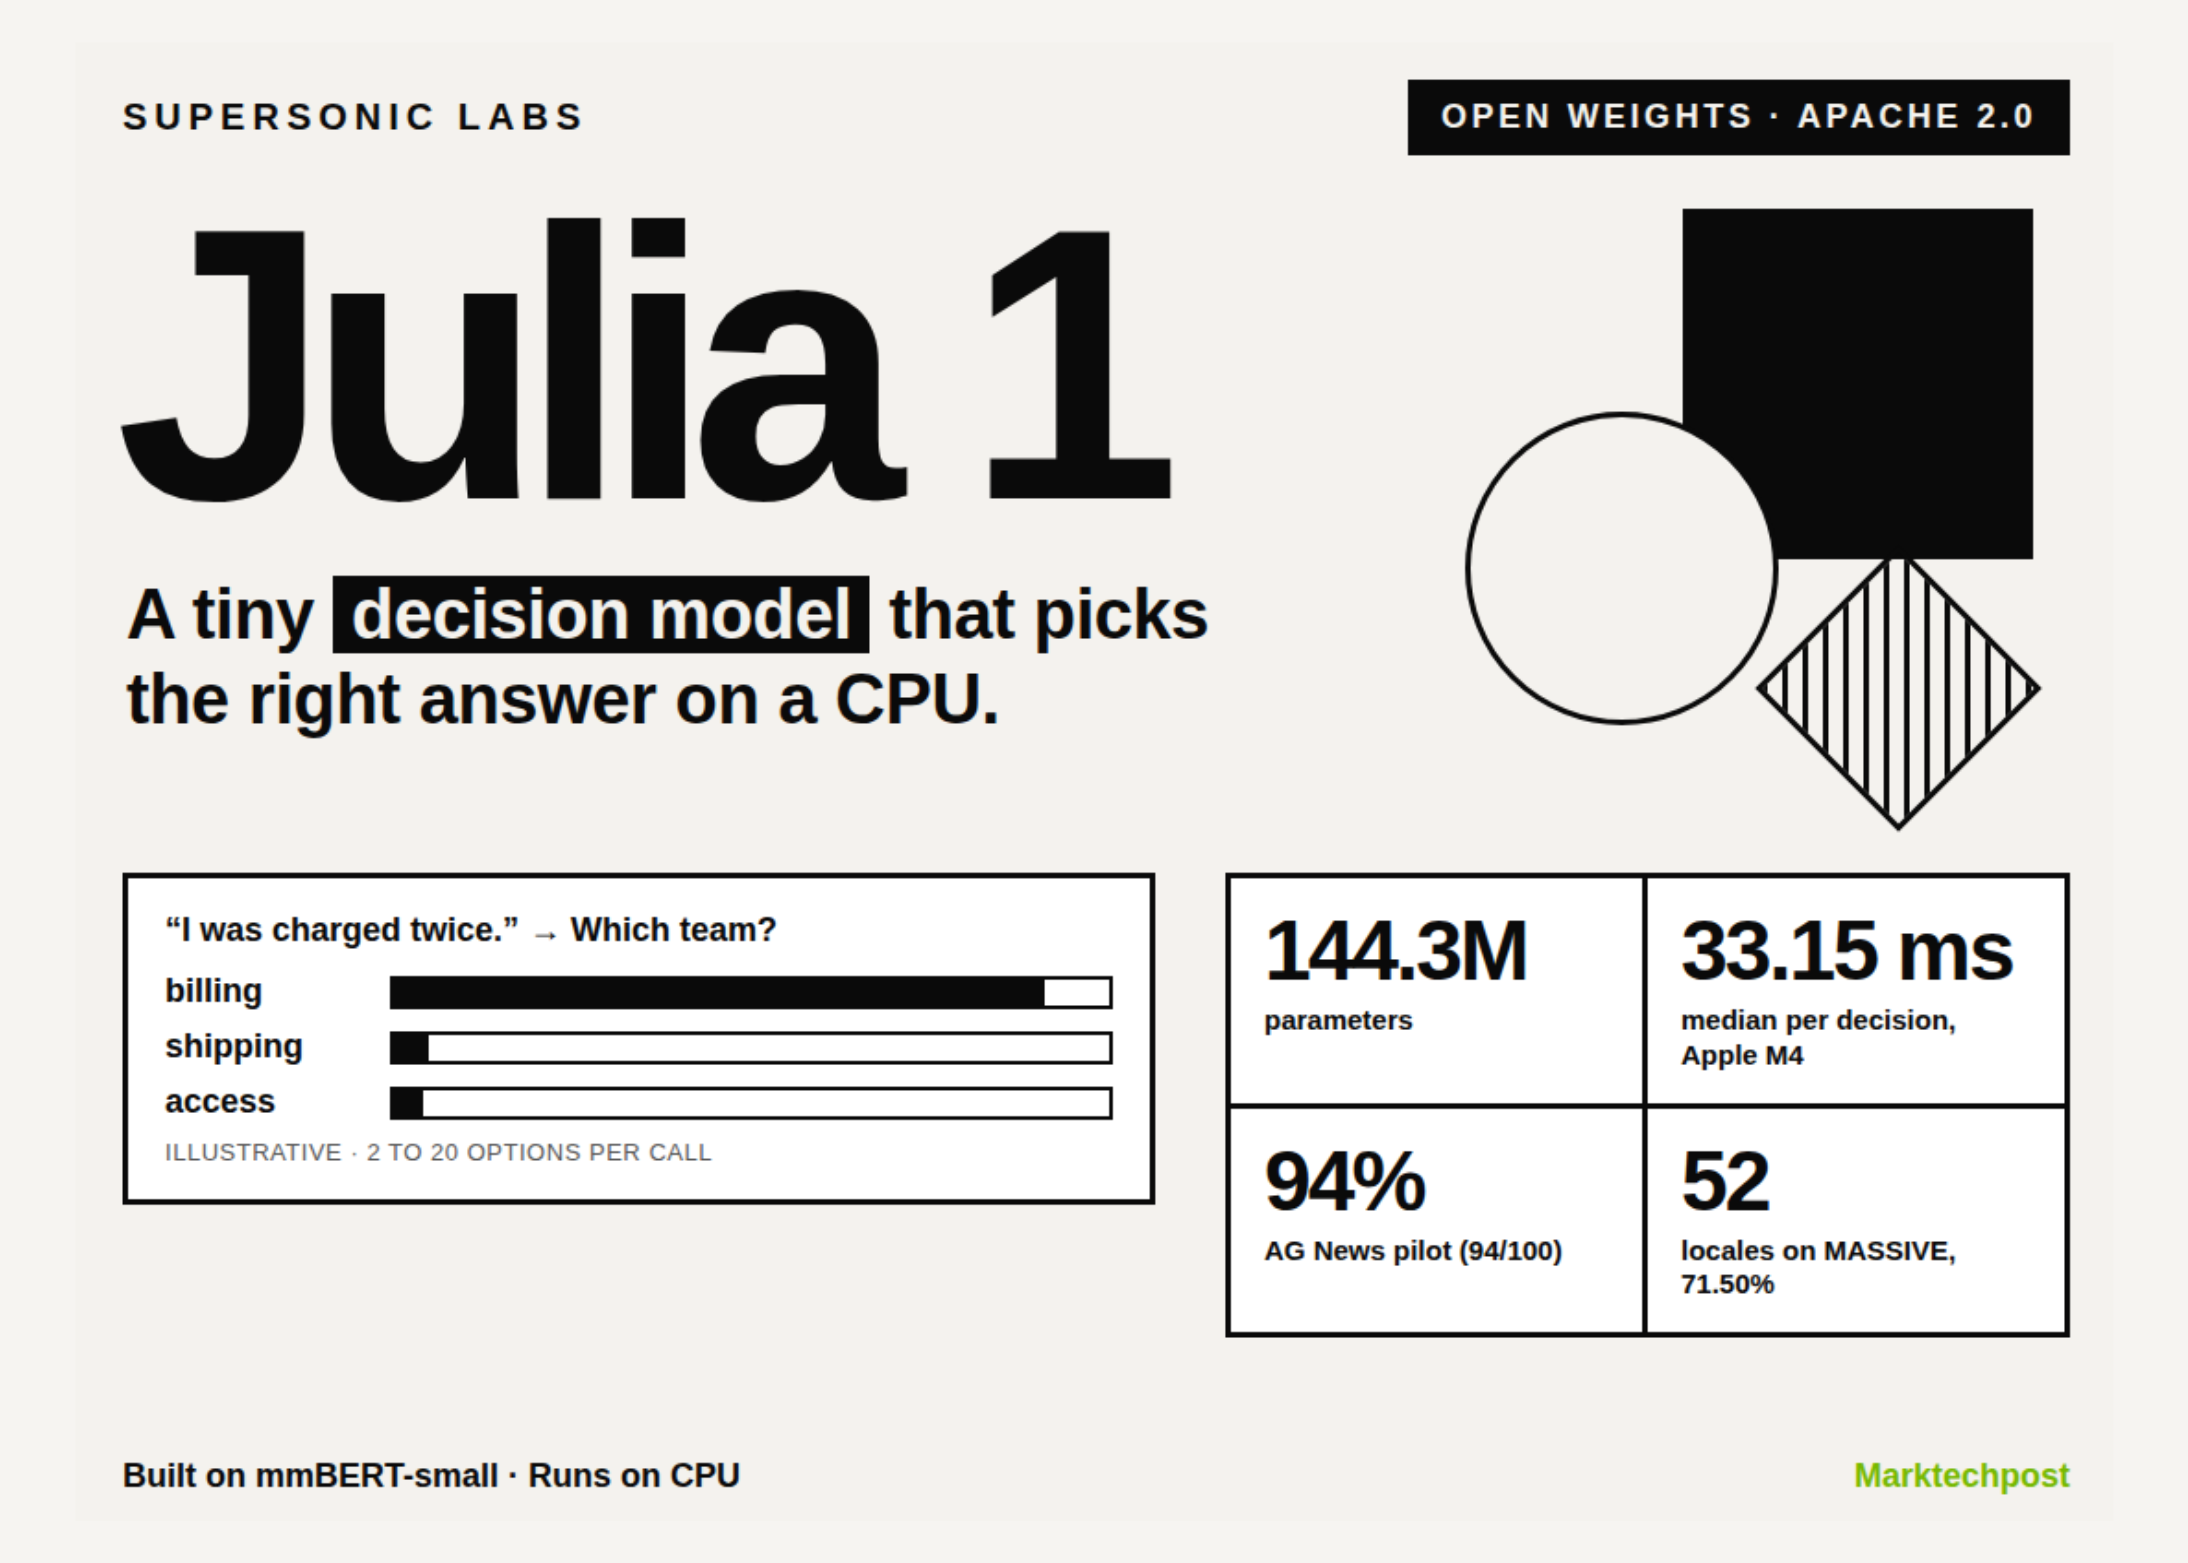
Segundo o MarkTechPost, em 26 de setembro de 2026, o pequeno laboratório brasileiro Supersonic Labs lançou o Julia 1 (nota: esta versão não está atualmente listada no catálogo KimiSeek; a disponibilidade de API mencionada na reportagem refere-se ao lado do fornecedor). Trata-se de um modelo de decisão, não de chat: o chamador fornece contexto, pergunta e de 2 a 20 respostas candidatas com descrições, e o modelo retorna o item selecionado na ordem dada, com probabilidades softmax completas; o ID do chamador é devolvido como está, sem geração de texto livre. Os pesos foram publicados sob Apache 2.0 no Hugging Face (a obtenção dos pesos não equivale a ter licença open source; aqui a fonte indica explicitamente Apache 2.0) e podem rodar em CPU ou GPU com suporte a BF16 em ambientes Python 3.11+, além de uma build ONNX para execução no navegador via WebGPU; a API hospedada foi anunciada, mas ainda não está aberta. O modelo é baseado no codificador mmBERT-small do JHU CLSP com uma cabeça de decisão, e o laboratório afirma explicitamente que não é um ajuste fino do Qwen. O limite de tokens mesclados em tempo de execução é 8.192, e os benchmarks públicos usam 1.024. Os três tipos de chamada são choice (classificação, roteamento), score (pontuação ordenada que retorna o índice esperado) e noul (probabilidade de ser verdadeiro/falso). A avaliação de 24 de setembro de 2026 na reportagem foi executada em H200 BF16 com codificação estrita, comparando com valores de referência do protocolo de benchmark TypeSafe Jev, e não com uma reexecução do Jev: Typed Decisions 73,15% (referência 72,70%), AG News 94/100 (referência 91%), DAIR Emotion 86/100 (referência 48%), Banking77 apenas 64/100 (referência 87%), MASSIVE com média macro de 71,50% em 52 regiões linguísticas, pt-PT 86,25%, en-US 86,75%. Os testes de classificação usaram apenas 100 amostras cada. Uma execução em CPU em 25 de setembro reproduziu Typed Decisions 72,55%, Banking77 60/100 e 3 abstenções. Em latência, a reportagem afirma mediana de 33,15 ms por decisão em Apple M4, mediana de 203 ms e RSS de pico de 393,1 MB em tablet Samsung SM-X510 via ONNX Runtime, mediana de 107,83 ms no AG News em Intel Core i5-1235U, enquanto o Banking77 exigiu 3.713,54 ms por precisar restringir primeiro os 72 rótulos.
Impacto para desenvolvedores
O impacto direto para desenvolvedores é o surgimento de um caminho opcional que separa "classificação/roteamento/pontuação" dos grandes modelos e as coloca em um modelo pequeno no dispositivo. Com 144,3 milhões de parâmetros e pesos FP32 de cerca de 550,5 MiB, ele pode caber em celulares, tablets, notebooks e até no navegador, sem pagar por chamada de classificação ou depender de rede; o preço planejado da API citado na reportagem é US$ 0,025 por milhão de tokens de entrada, mas essa API ainda não está aberta, e o preço foi reportado em setembro de 2026, portanto o leitor deve confirmar o preço atual na página mais recente do fornecedor, e não neste texto. Ao mesmo tempo, é preciso ver claramente os limites de capacidade: ele só compara entre os candidatos fornecidos, não preenche fatos ausentes, não faz álgebra ou cálculos de múltiplas etapas, o Router pode descartar rótulos corretos durante a restrição e não é um componente que substitua diretamente pipelines Transformers existentes; a reportagem afirma que nenhum provedor de inferência do Hugging Face o hospeda. No nível dos benchmarks, o sinal mais importante não é "três itens superaram o Jev", mas a degradação acentuada quando o espaço de rótulos cresce de 4 ou 6 para 72: AG News 94/100 contra Banking77 64/100, e a reprodução em CPU com apenas 60/100, o que indica que ele é mais adequado para decisões de granularidade grossa e poucos rótulos do que para classificação fina com muitos rótulos. Além disso, a afirmação de "5 vezes mais rápido que o Jev" vem de uma postagem no X do fornecedor, enquanto os testes do Jev foram medidos chamando o Jev como serviço hospedado a partir da França; a latência não é uma comparação em condições iguais e não deve ser aceita diretamente.
Integração e avaliação
As considerações e recomendações a seguir são análises condicionais baseadas na reportagem, não fatos verificados. Primeira decisão: usar ou não a saída do modelo diretamente como roteamento automático em produção. Na reportagem, "quanto mais rótulos, pior" (Banking77 64/100, CPU 60/100) e "o Router pode perder rótulos" são duas mudanças distintas e devem ser tratadas separadamente; se o seu cenário tiver mais de cerca de vinte rótulos e um erro puder acionar cobrança, permissão ou reembolso irreversível, recomenda-se não executar diretamente a saída do modelo, mas sim adicionar uma segunda verificação ou revisão humana; se houver poucos rótulos (por exemplo, classificação grosseira com até 4 classes) e as ações forem reversíveis, pode-se começar com implantação gradual. Critério mensurável: em pelo menos 200 requisições reais amostradas por você, comparar a taxa de concordância entre o item selecionado pelo modelo e a anotação humana, e medir separadamente a proporção de "respostas corretas excluídas na etapa de restrição do Router". Segunda decisão: substituir chamadas de classificação hospedadas por implantação no dispositivo. Os testes de dispositivo citados na reportagem são mediana de 33,15 ms no M4, mediana de 203 ms no SM-X510, mediana de 107,83 ms no AG News em i5-1235U, e 3.713,54 ms no Banking77, o que significa que a quantidade de candidatos ou o tamanho do conjunto de rótulos é uma precondição para a viabilidade; quando suas requisições forem principalmente textos curtos com poucos rótulos e você puder aceitar inferência local na casa das centenas de milissegundos, sem rede, o dispositivo tende a compensar; quando o conjunto de rótulos for grande ou houver necessidade de baixa latência e alta concorrência, o caminho de CPU no dispositivo pode não ser viável. Critério mensurável: no seu dispositivo alvo, com comprimento de entrada fixo, testar separadamente P50 e P95 de latência e memória de pico por tipo de decisão (referência citada: RSS 393,1 MB) e comparar com a solução atual na mesma máquina. Terceira decisão: migrar agora o negócio para a API hospedada. A reportagem afirma claramente que a API foi anunciada, mas ainda não está aberta, portanto neste momento só é possível auto-hospedar; sugere-se primeiro usar os pesos locais para validação em pequena escala, confirmar disponibilidade, limites de taxa e cobrança no lado da API antes de decidir a troca, e não fazer planejamento de capacidade com base no preço planejado da reportagem. Em termos de etapas de avaliação, recomenda-se primeiro fixar entradas de até 1.024 tokens e construir candidatos conforme os critérios do relatório, fazer testes offline de concordância, depois testes de estresse no dispositivo, e só então avançar para implantação gradual quando ambos os critérios forem atendidos.
Limites e pontos a confirmar
A principal limitação desta reportagem está nas amostras e nos critérios de comparação. Os testes de classificação usaram apenas 100 amostras cada; embora Typed Decisions tenha 2.000 itens, os demais têm intervalos de confiança amplos, insuficientes para conclusões fortes; a linha de base compara valores de referência do protocolo Jev, e não uma reexecução do Jev no mesmo ambiente, além disso a latência do Jev foi medida chamando um serviço hospedado a partir de outro país, o que não é comparável à execução local deste modelo, portanto a afirmação do fornecedor de "5 vezes mais rápido" precisa de verificação independente. O pipeline de treinamento privado do modelo não foi divulgado, impossibilitando verificar a composição dos dados e possíveis vieses. A reprodução em CPU de 25 de setembro apresentou 3 abstenções, indicando que o comportamento pode degradar em ambientes de baixo desempenho. A API hospedada alegada na reportagem ainda não estava aberta no momento da redação deste texto; o preço planejado de US$ 0,025 por milhão de tokens de entrada vem de uma reportagem de setembro de 2026, preços mudam, consulte a página de preços do fornecedor. É importante esclarecer: a versão Julia 1 não está atualmente listada no catálogo KimiSeek; a disponibilidade de API mencionada na reportagem refere-se aos planos do lado do fornecedor e não tem relação com a plataforma KimiSeek. Além disso, a reportagem não fornece detalhes como redação das respostas candidatas, sensibilidade à ordem e estabilidade multilíngue (MASSIVE reporta apenas média macro e duas regiões linguísticas), que podem afetar o desempenho real e exigem testes próprios do leitor para confirmação.
Ilustrações da notícia original