Underdog lança Saluki 27B: Qwen3.8-27B de 2 bits com 7,89GB
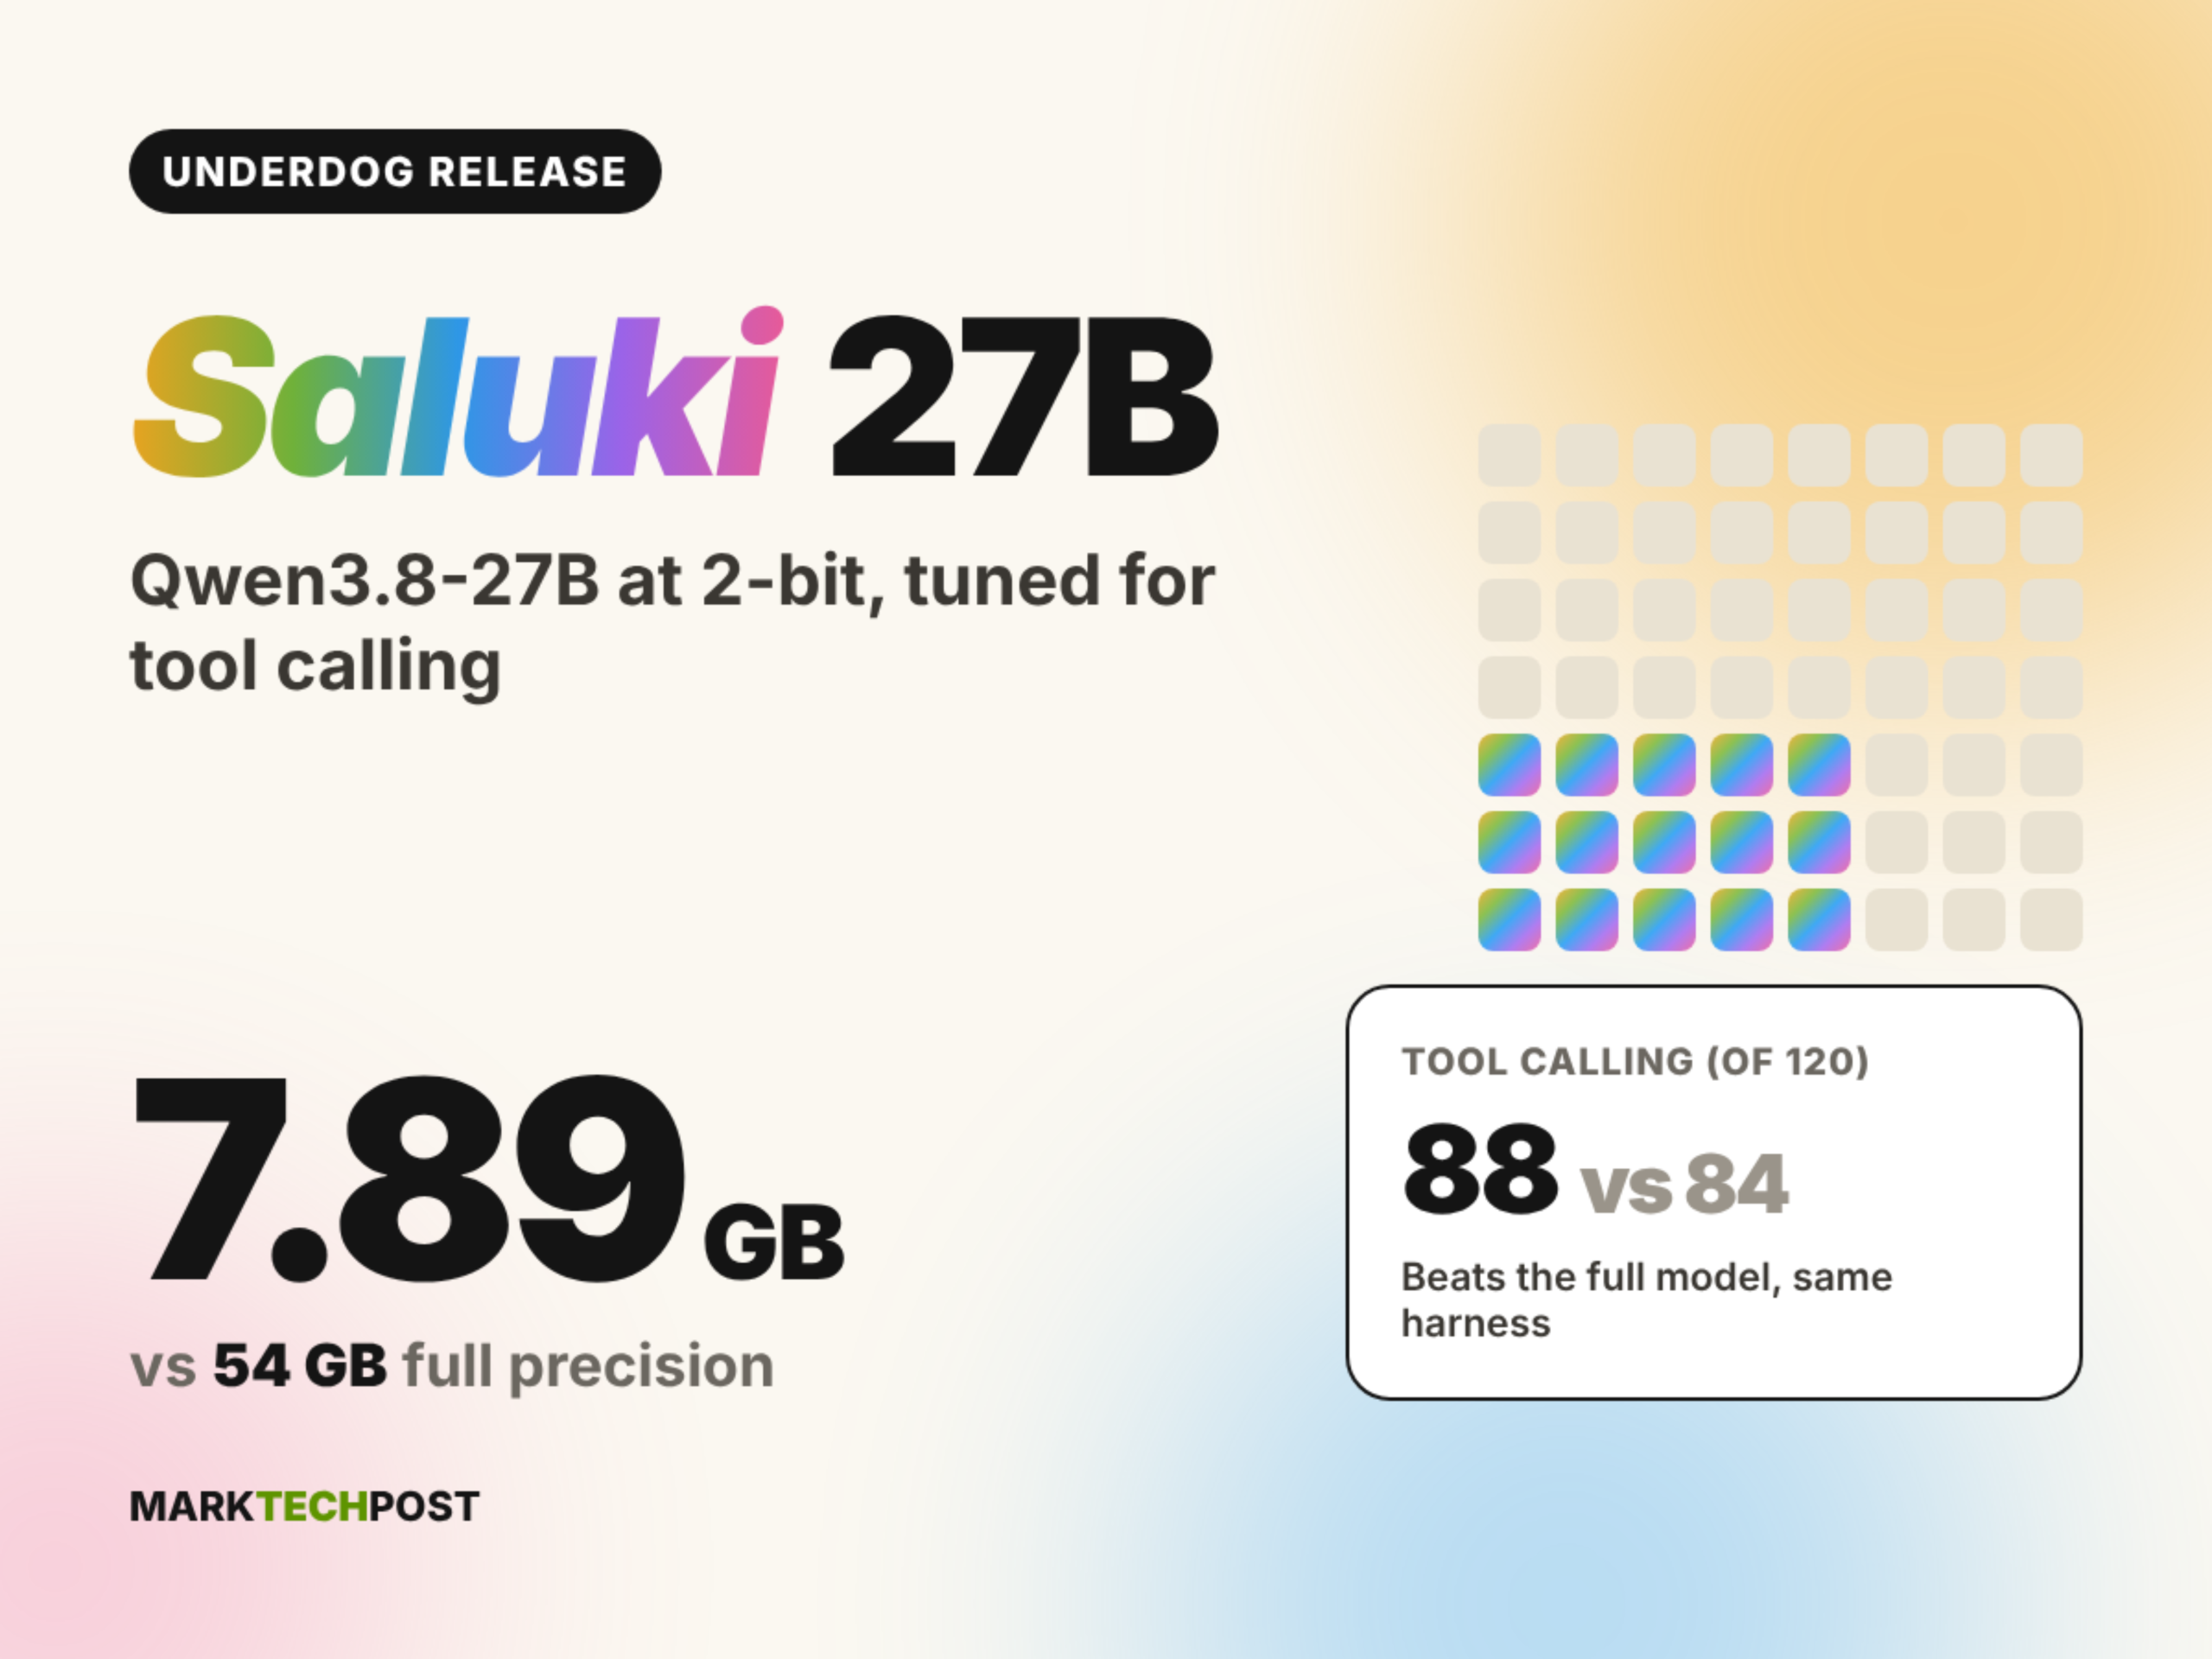
Segundo o MarkTechPost de 9 de outubro de 2026, a Underdog, da Conway Research, lançou o Saluki 27B sob Apache 2.0, comprimindo o Qwen3.8-27B de 54GB para um GGUF misto de 2 bits de 7,89GB executável no llama.cpp original; a pontuação de chamadas de ferramentas supera o original, mas matemática de competição e raciocínio multi-etapas ficam de 12 a 18 pontos atrás.
O que mudou
Segundo o MarkTechPost de 9 de outubro de 2026, o projeto de assistente em dispositivo Underdog, da Conway Research, lançou o Saluki 27B sob licença Apache 2.0. O modelo é uma versão GGUF de precisão mista de 2 bits do Qwen3.8-27B, com arquivo de 7,89GB, enquanto o modelo BF16 completo tem 54GB. A reportagem afirma que sua construção sobrepõe três camadas de trabalho: a base é o modelo denso de 27B da equipe Qwen, Qwen3.8-27B (64 camadas, atenção linear Gated DeltaNet mista com atenção com portão, 262.144 tokens nativos); sobre ela, o GSQ-RCO GGUF do ISTA-DASLab, cujo menor arquivo IQ2_XS tem 8,4GB e média de 2,50 bits por peso; a Underdog então faz sua própria compressão e otimização de chamadas de ferramentas, produzindo um arquivo chamado IQ2-mix, marcado com imatrix, mas a reportagem aponta que a Underdog ainda não divulgou a receita completa dessa etapa. No nível de execução, a reportagem afirma que o modelo roda diretamente no llama.cpp original e em aplicativos baseados nele, com suporte a offload completo para GPU, além de um módulo visual opcional de 629MB ou 928MB. Em benchmarks, a reportagem apresenta dois conjuntos de resultados declarados pela Underdog: em uma comparação com o modelo completo no mesmo framework, o Underdog Bench (120 tarefas do BFCL v4, modo de pensamento desativado, temperature 0) dá ao Saluki 88 pontos contra 84 do modelo completo; chamadas paralelas de ferramentas 42 contra 35; SWE-bench Verified com 50 issues corrigidas 30 contra 33. Em comparação com pontuações públicas de tamanho completo, IFEval 93,5 contra 91,5, IFBench 72,7 contra 71,0, MBPP+ 78,0 contra 83,9, MuSR 67,5 contra 79,6, AIME 2025 79,2 contra 96,7, AIME 2026 80,0 contra 94,6. A reportagem também lista o ISTA GSQ-RCO IQ2_XS e o PrismML Bonsai 2 27B como referências e enfatiza que cada fornecedor usa seu próprio framework de teste, de modo que pontuações entre fornecedores não são diretamente comparáveis; o Bonsai 2 é menor, mas exige o branch do llama.cpp da PrismML.
Impacto para desenvolvedores
Para desenvolvedores que precisam de agentes locais, a mudança substancial desta notícia é: um modelo de chamadas de ferramentas de nível 27B, com pesos quantizados para menos de 8GB, que pode ser carregado sem um branch de llama.cpp de terceiros. Isso altera diretamente o cálculo de VRAM e da barreira de implantação — o offload completo em uma GPU de consumidor de placa única ou mesmo em uma máquina com muita memória torna-se realista, e a arquitetura híbrida de "loop de agente local + modelo remoto como fallback" torna-se mais calculável em custo. Mas é preciso distinguir pesos abertos de direitos de licença: a reportagem afirma que o arquivo é lançado sob Apache 2.0, o que é uma declaração no nível da licença; se pode ou não ser usado comercialmente ainda deve ser verificado no model card e no texto original da licença, e o fato de os pesos serem baixáveis não equivale ao escopo de autorização da licença. Além disso, é preciso notar que a distribuição de capacidades não é uniforme: a reportagem afirma que métricas de chamadas de ferramentas e seguimento de instruções ficam próximas ou ligeiramente acima do original, enquanto métricas de matemática e raciocínio multi-etapas como AIME e MuSR caem de 12 a 18 pontos. Isso significa que esta versão quantizada é adequada para cargas de orquestração de ferramentas, seleção de funções e restrições de formato, e não para ser usada como força principal de raciocínio. Além disso, todas as pontuações vêm de autotestes da Underdog ou de fornecedores por ela citados, e diferentes fornecedores usam frameworks de teste diferentes; trata-se de declarações reportadas, não de reprodução independente, e rankings entre modelos devem ser considerados não comparáveis. A reportagem não divulga bits por peso, comprimento de contexto nem receita de compressão; essas incógnitas afetam o desempenho real em contexto longo e concorrência em lote.
Integração e avaliação
Recomendação um (roteamento de chamadas de ferramentas): se usar o Saluki 27B como camada local de seleção de funções e geração de parâmetros de agente depende de sua carga ser principalmente chamadas paralelas de ferramentas e saída estruturada. Se seu cenário for de turno único ou poucas chamadas paralelas e formato de resposta rigoroso, a reportagem afirma que suas métricas de chamadas paralelas de ferramentas e seguimento de instruções ficam próximas ou acima do original, podendo rodar localmente com prioridade; se sua carga depender de planejamento multi-etapas em cadeia longa, a reportagem afirma que MuSR e AIME caem claramente, então convém manter o original ou um modelo mais forte como fallback. Critério de avaliação mensurável: rodar o mesmo conjunto de tarefas congeladas sobre seu próprio schema de ferramentas, comparando a precisão de seleção de nomes de ferramentas e a taxa de JSON de parâmetros válido entre Saluki e o original (ou o modelo atualmente em produção), além da taxa de conclusão de tarefas em cenários de chamadas paralelas. Recomendação dois (escolha de esquema de compressão): escolher entre candidatos na mesma faixa de 2 bits depende de você aceitar manter um runtime não original. A reportagem afirma que o Saluki roda no llama.cpp original, enquanto o PrismML Bonsai 2 exige seu branch do llama.cpp, o que afeta diretamente a complexidade de build, atualização e CI; ao mesmo tempo, a reportagem afirma que o Saluki não divulga bits por peso e contexto, enquanto a alternativa divulga 2,50 bits por peso e tamanho de arquivo. Se sua equipe não quiser bifurcar o framework de inferência, pode tratar "carregável no llama.cpp original" como premissa rígida e então comparar tamanho e precisão; se o tamanho for a restrição principal, será preciso aceitar o custo de manutenção do branch. Critério de avaliação mensurável: registrar na mesma máquina de destino a latência até o primeiro token, o pico de VRAM e a estabilidade em contexto longo (próximo ao seu comprimento máximo real de entrada), e verificar os requisitos de versão do llama.cpp para carregar o arquivo. Recomendação três (aceitação pós-quantização): independentemente do lado escolhido, usar como critério de entrada em produção "se ainda completa tarefas ponta a ponta após a quantização" em vez de pontuações de benchmark. Critério de avaliação mensurável: usar uma amostra do seu tráfego real em produção para comparar o número de tarefas de correção aprovadas, rodadas de chamadas de ferramentas e taxa de repetição de falhas, e definir um limite claro de rollback, por exemplo, reverter automaticamente quando a taxa de conclusão ponta a ponta ficar abaixo de uma proporção aceitável em relação ao original. O acima são análises e recomendações condicionais, não afirmações factuais da reportagem.
Limites e pontos a confirmar
Primeiro, é preciso deixar claro: o Saluki 27B da reportagem (versão derivada GGUF de 2 bits do Qwen3.8-27B) atualmente não aparece no catálogo de modelos do KimiSeek; a forma de distribuição descrita na reportagem é obter os pesos GGUF em canais como o Hugging Face e rodar localmente no llama.cpp original, sem envolver disponibilidade de API na plataforma KimiSeek, e qualquer afirmação sobre disponibilidade de API refere-se aos canais do próprio lançador. Segundo, todos os números de benchmark no texto são reportados a partir de autotestes da Underdog e pontuações públicas por ela citadas, sendo declarações do lançador; este artigo não fez reprodução independente; a própria reportagem também alerta que cada fornecedor usa seu próprio framework de teste e que pontuações entre fornecedores não são diretamente comparáveis. Terceiro, a reportagem não divulga bits por peso, comprimento de contexto nem a receita completa da terceira camada de compressão, portanto o desempenho em contexto longo, concorrência em lote e diferentes hardwares permanece desconhecido. Quarto, a publicação dos pesos sob Apache 2.0 é uma declaração de licença da reportagem; se atende a condições comerciais específicas deve ser verificado no model card e no texto original da licença, e a disponibilidade dos pesos não equivale a um escopo de autorização claro. Por fim, a descrição das capacidades da base Qwen3.8-27B (64 camadas, atenção mista, contexto nativo de 262.144) também vem dessa reportagem, sem verificação neste artigo.