Aleph Alpha 发布开放权重 Kolibri:781 亿参数 MoE、单 token 激活 34.6 亿
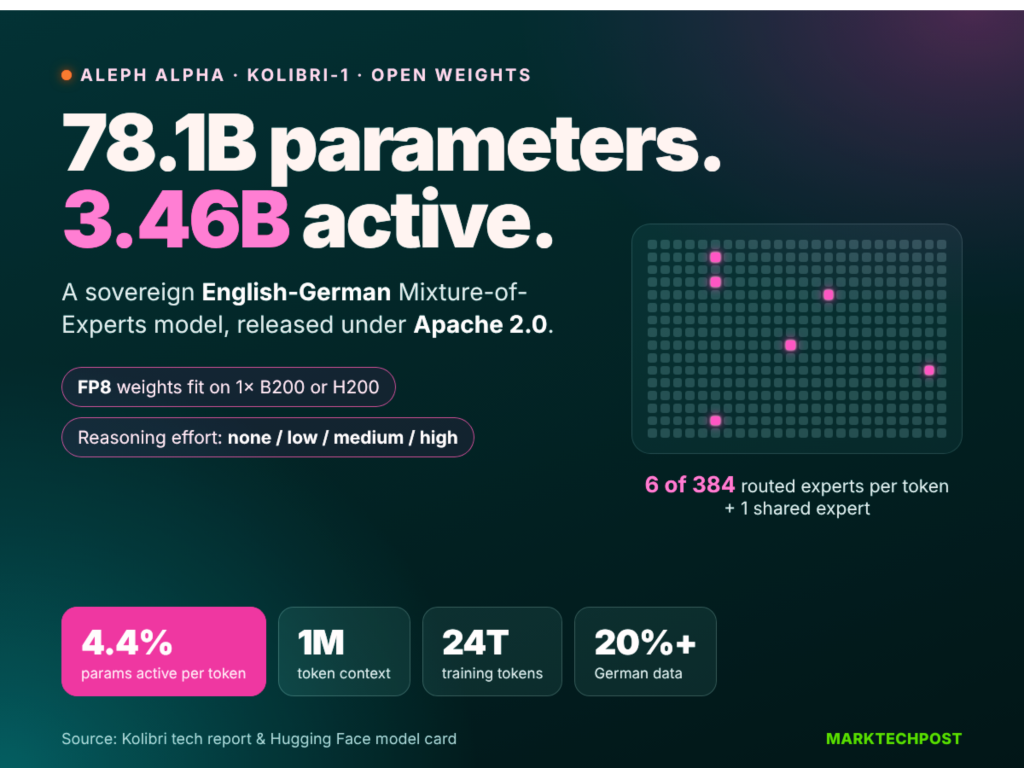
据 MarkTechPost 2026 年 10 月 4 日报道,Aleph Alpha 发布英德双语开放权重 MoE 模型 Kolibri-1,总参数 781 亿、每 token 仅激活 34.6 亿,支持最长 1,048,576 token 上下文与四档推理强度,以 Apache 2.0 许可在 Hugging Face 发布,FP8 检查点约 78GB,可用 vLLM 在单张 B200 或 H200 上服务。
发生了什么
据 MarkTechPost 2026 年 10 月 4 日报道,德国团队 Aleph Alpha 发布开放权重模型 Kolibri(Kolibri-1),定位为英语与德语双语混合专家(MoE)语言模型,目标是公共管理、工业与航空航天等受监管领域的主权部署。报道称其总参数量 781 亿,每个 token 仅激活 34.6 亿(约 4.4%):每个 MoE 层用 sigmoid 路由器在 384 个路由专家中选 top 6,另加 1 个共享专家,负载均衡采用 Exact Quantile Balancing 与 Load-Error Injection。模型堆叠 50 个 Transformer 块,宽度 2560,分组查询注意力为 48 个查询头、4 个 KV 头;每第五个块为无位置编码的全注意力,其余 40 个块为覆盖前 512 token 的滑动窗口注意力配合 RoPE,因而只有 10 层 KV 缓存随上下文增长。上下文上限报道为 1,048,576 token,推理强度可按请求设为无、低、中、高。训练方面,报道称预训练在 768 张 NVIDIA B200 上覆盖 20T token,中期训练 3.44T token(序列长 65,536),长上下文阶段 201B token(序列长 262,144),并额外加入超过 2T 德语 token;后训练结合监督微调与在超过 120 万条内部任务上的强化学习。许可为 Apache 2.0,权重发布在 Hugging Face;FP8 检查点约 78GB,可用单张 B200、B300 或 H200,或两张 H100 SXM5,通过 vLLM 配合专用推理解析器与工具调用解析器提供服务。报道中的基准对比显示其英语总体 75.5、德语总体 70.8,BFCL v4 得 61.4 低于所对比的 Qwen3.5。上述参数、基准与部署细节均为原报道与技术报告转述,尚未经独立复现。
对开发者的影响
从开发者视角看,这条消息的价值集中在三点。第一是许可与自托管的组合:报道称权重以 Apache 2.0 许可发布,这比“开放权重但限制商用”的常见做法给出了更明确的授权空间,但许可条款应回到 Hugging Face 模型卡与仓库许可证原文核对,不要仅凭报道转述推断权利;同时注意权重可用不等于训练数据、分词器或推理包同样受同一许可约束。第二是稀疏度带来的成本结构:781 亿总参数、34.6 亿激活意味着显存占用按总参数计、算力开销按激活参数计,报道称 FP8 检查点约 78GB 可在单张 B200/H200 上运行,这对已有单卡高显存节点的团队是可行的自托管起点,但真实吞吐与并发仍取决于显存带宽、KV 缓存精度与批大小,需要自测。第三是混合注意力与百万上下文:滑动窗口层保持固定 KV 缓存、仅 10 层随上下文增长,团队称同算力下可支持的序列长度是全注意力方案的 4 倍,若属实,长文档与工业 RAG 的上下文经济性会明显优于同规模稠密模型;但这属于厂商声明,需在自身文档分布上验证有效上下文而非仅看上限数字。此外,英德双语定位与为德语优化的分词器(报道称德语每 token 4.90 字节、比所对比的分词器少用约 11.2% token)说明其优势区域在德语;以中文为主的业务不应据此推断中文能力,报道没有给出中文评估。需要明确的是:截至本次目录核对,Kolibri-1 这一版本未出现在 KimiSeek 的实时模型目录中,因此报道中的权重与推理服务可用性指的是 Aleph Alpha 及 Hugging Face 侧的发布,而非本站已上线。
接入与评估建议
以下为建议与条件性分析,不是已证实的事实。建议一:先按许可与合规前提决策,再做性能决策。实际选择是核对 Hugging Face 仓库的 LICENSE 文件、模型卡中的用途限制,以及 aleph-alpha-inference 推理包自身的许可,再决定是否纳入生产依赖。当工作负载涉及受监管数据的本地处理、且团队具备单张 B200/H200 级显存节点时,自托管比调用外部 API 更有价值;若不满足该前提(例如只有消费级或多张中小显存卡),应按可量化标准放弃:以在目标硬件上成功加载 FP8 检查点并稳定输出为通过门槛,加载失败或需要超出预算的显存扩展即不进入下一轮。建议二:在切换或引入前,用自有德语或英德混合语料做一次与现有模型的对照评估。可选择的关键变量是推理强度档位(无/低/中/高)与 KV 缓存精度,因为它直接改变单请求成本与延迟;当任务属于长文档抽取、且对答案延迟容忍度较高时,提高推理强度可能带来质量收益,而当任务属于高并发短问答时,低强度配合更长批处理更划算。评估标准要可测:在固定 200 至 500 条德语长文档问答集上,比较每档的准确率与每千 token 端到端延迟,只有在准确率提升幅度超过延迟与成本增幅时才采用更高档位。建议三:长上下文能力必须按“有效窗口”而非上限验证。实际选择是先用默认 262,144 上下文上线,再通过设置 max-model-len 与覆盖 max_position_embeddings 逐步放开到更大窗口;前提是任务确实需要跨百万 token 的连续依赖,若任务检索结果本就短于十万 token,放开上限只会抬高 KV 缓存成本。可量化标准为在长度梯度(如 32k、128k、512k)上测量关键信息召回率,若在某一长度出现明显下降,就把该长度以下作为实际上限使用。建议四:工具调用与 agent 场景应单独压测。报道称其在 BFCL v4 上得分低于所对比的 Qwen 模型,而 agentic 平均分与对手接近,说明不同 agent 子任务的差距可能很大;实际选择是保留现有模型作为工具调用主链路、把 Kolibri 用于德语检索与生成,或反之。前提是团队已有一套可回归的工具调用测试集;可量化标准为在自身工具 schema 上的调用成功率与参数正确率,若显著低于现用模型则不要迁移主链路。
限制与待确认事项
首先,必须明确指出:截至本次目录核对,Kolibri-1 未出现在 KimiSeek 的实时模型目录中,本文所述权重、推理包与部署方式均指 Aleph Alpha 及其 Hugging Face 发布,不代表本站已提供该模型;报道中的任何 API 可用性表述也只针对厂商侧,不应理解为本站服务。其次,本文所有架构、训练、基准与部署数字均来自 MarkTechPost 2026 年 10 月 4 日的报道及其转述的技术报告与模型卡,未经独立复现;基准对比用的是厂商自建评估配置,跨模型横向比较的可比性有限,不应作为选型唯一依据。第三,报道未给出中文、代码或长上下文场景的独立验证细节,英德双语定位之外的语种能力未知;其“同算力下 4 倍序列长度”的说法属团队声明,需要自行验证。第四,Apache 2.0 是针对所发布权重的许可声明,具体适用范围(权重、分词器、推理包、训练数据)应逐项核对原始许可证与模型卡,不能从“开放权重”直接推导出全部组件的授权范围。第五,单卡可运行与生产可用是两回事,峰值并发、显存余量、推理强度档位对成本的影响都需要在目标硬件上实测。第六,报道中的价格、上限与推荐采样参数均为发布时点的信息,可能随后续版本变化,请以厂商与 Hugging Face 页面最新内容为准。