EmbeddingGemma 2 开放权重发布:7.4 亿参数共享 768 维空间,代码与音频检索成新变量
据 MarkTechPost 2026 年 10 月 6 日报道,Google DeepMind 发布 EmbeddingGemma 2,7.4 亿参数、8K 上下文、Apache 2.0 许可的开放权重多模态嵌入模型,把文本、代码、图像、视频、音频映射进同一 768 维空间。文本主干 2.7 亿参数可单独加载。
发生了什么
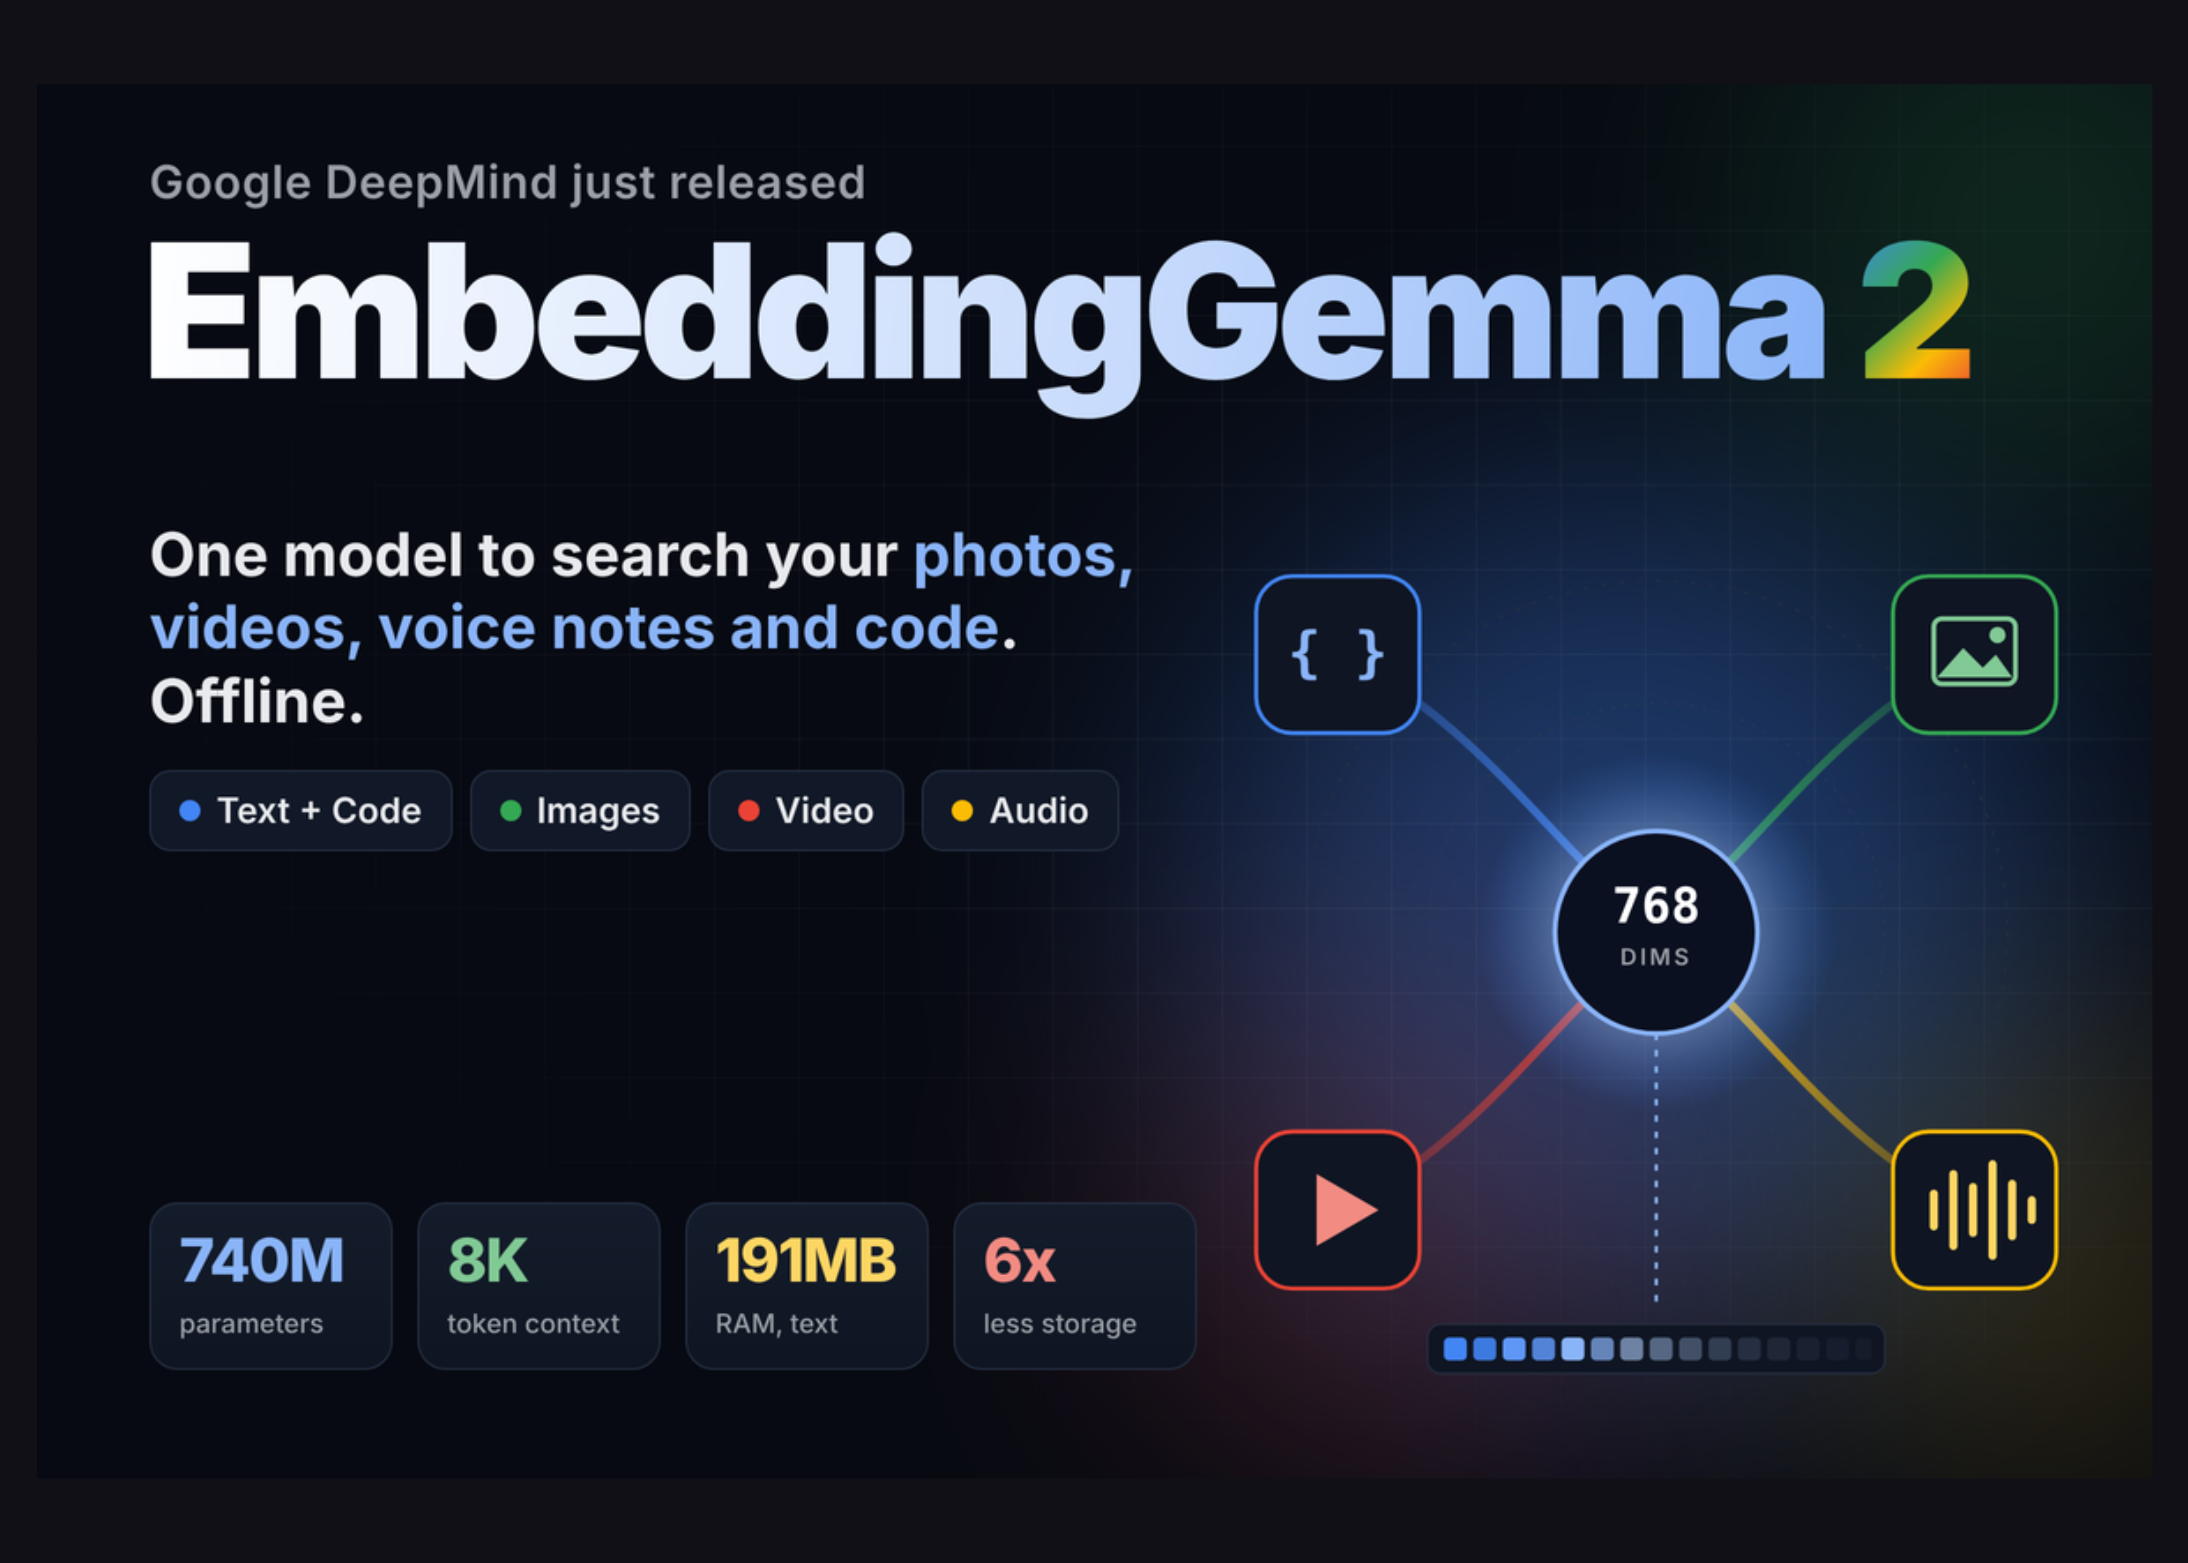
据 MarkTechPost 2026 年 10 月 6 日报道,Google DeepMind 发布 EmbeddingGemma 2,一个基于 Gemma 4 架构的开放权重多模态嵌入模型,采用 Apache 2.0 许可。它以模块化编码器把不同模态映射进同一个 768 维向量空间:文本与代码主干约 2.7 亿参数(1.3 亿 transformer 加 1.4 亿 embedder),视觉编码器 1.7 亿参数可选,音频编码器 3 亿参数可选,全部加载共约 7.4 亿参数,开发者可按需只加载所需部分。上下文窗口为 8192 token,报道称是第一代的四倍,约可容纳 29 张图像、58 个视频帧或 5.5 分钟音频。据模型卡,MTEB Code v1 从上一代 68.76 提升到 78.68,MTEB multilingual v2 从 61.15 到 61.36,并新增 MIEB lite 图像 64.64、MMEB v2 总分 59.01、MAEB 音频 49.39 等指标。报道称权重已上线 Hugging Face 和 Kaggle,并提供 Ollama、llama.cpp GGUF、LiteRT、sentence-transformers v6.1.0+、vLLM、SGLang、MLX、LM Studio、MediaPipe 等运行方式,向量存储由 Qdrant 支持、微调由 Unsloth 支持;MRL 支持把向量截断到 512、256、128 维。
对开发者的影响
对开发者而言,这次发布的关键变化不是参数量,而是同一向量空间同时覆盖代码与音频,并且可以只加载文本主干。这直接改变了三类选型判断。第一,多模态 RAG 的检索层过去往往需要文本与图像两套嵌入模型、两套索引和分数归一化逻辑;报道称纯文本配置生成的查询向量可以匹配完整模型生成的文档向量,若能复现,意味着可以先用 2.7 亿参数主干建索引,再按需加入视觉或音频编码器而不重建库。第二,代码检索基准的提升幅度(报道称约 9.92 分、约 14%)使它在代码库语义搜索场景进入候选名单,但这是厂商模型卡数字,不等于在自有仓库上的表现。第三,它与阿里的 Qwen3-VL-Embedding-2B 形成不同取舍:据报道后者在自己的 MMEB v2 测试中报告 73.2 分,参数量约为其 2.7 倍,且不支持音频;而 EmbeddingGemma 2 强调 8K 上下文、端侧内存与音频支持。需要注意开放权重不等于无约束的开放源代码许可:Apache 2.0 属于宽松许可,但模型报告中的训练数据来源与下游合规要求仍需自行核对。另外,KimiSeek 当前模型目录中没有任何名为 EmbeddingGemma 2 的条目,该版本目前未在 KimiSeek 上架;报道中提及的可用性指的是 Hugging Face、Kaggle、Ollama 等外部渠道,若未来有 API 形式提供,也应以其供应商页面为准。
接入与评估建议
以下为建议与条件分析,不是报道事实。建议一:先判定是否需要跨模态检索。若只有中文文本与代码,且已在使用成熟的文本嵌入模型,可把 EmbeddingGemma 2 当作 A/B 候选而非立即替换;先用同一批自有查询与文档做召回实验,评测指标用 Recall@10 与 nDCG@10,而不是只看 MTEB 分数。若工作负载确实包含图文混排或语音备忘检索,则值得优先验证其共享向量空间假设:用 2.7 亿文本主干建库,再用完整模型嵌入同一批图文文档,测量跨配置相似度一致性,如果相关性排序明显漂移,就需要为不同配置分别建索引。建议二:维度与存储的取舍。报道称 256 维时 MTEB multilingual 仅从 61.36 微降到 60.41,而 128 维时 MMEB 降至 45.65、官方建议 128 维主要用于纯文本。若你的瓶颈是向量库存储成本且场景为纯文本,可先切到 256 维验证;若涉及图像或视频检索,则保留 768 维,并在自有数据上比较 256 维与 768 维的召回差距,设置可接受的召回损失阈值再决定。建议三:部署栈的锁定风险。可运行栈较多,选择时应以你的服务端还是端侧目标为准,并把向量维度、提示模板(报道中的 SearchQuery 与 Document 提示名)与量化方式一起写入配置,用固定回归集在量化前后各跑一次,比较召回差异。评估时务必用企业自有数据而非公开榜单,因为多语言质量在报道中基本持平,提升集中在代码与新增模态。
限制与待确认事项
以上基准、内存占用与延迟数字均来自 Google 模型卡或研究团队自述,属于厂商报告,未经独立第三方复现;端侧 191MB 与 567MB 是特定设备(Pixel 11 Pro)量化后的活跃内存,不能直接外推到其他硬件。报道中未披露训练数据构成与语言分布细节,中文场景的实际表现需要自行验证。跨模型对比中 Qwen3-VL-Embedding-2B 的 73.2 分为其自身 MMEB v2 自报口径,片面对比与不同榜单的分数不可直接横向比较。此外,EmbeddingGemma 2 这一版本目前并未出现在 KimiSeek 的模型目录中,因此本文不将其视为 KimiSeek 上可用模型;报道中提及的权重上线、Ollama 拉取与各类运行时支持均指外部渠道的供应商或社区发布,相关可用性与未来价格请以对应平台的官方页面为准。报道提到面向 Android 的 ML Kit 支持将在几周内推出,这属于计划而非既成事实,不应据此排期。
原报道配图