EmbeddingGemma 2 发布:7.4 亿参数多模态嵌入模型,Apache 2.0 开放权重
据 Google DeepMind 2026 年 10 月 6 日官方博客,EmbeddingGemma 2 以 Apache 2.0 许可发布,7.4 亿参数,可将文本、代码、图像、音频、视频映射到统一嵌入空间,支持 8K 上下文与可截断向量维度。

发生了什么
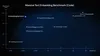
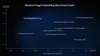
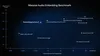
据 Google DeepMind 于 2026 年 10 月 6 日发布的官方博客,Google DeepMind 推出 EmbeddingGemma 2,一个面向端侧推理的多模态嵌入模型。该模型基于 Gemma 4 架构构建,参数量为 7.4 亿,以 Apache 2.0 许可证发布。来源称其可原生将文本、代码、图像、音频与视频的组合映射到统一嵌入空间,采用与 Gemini Embedding 同源的技术。来源报告的设计要点包括:纯文本场景最少约 2.7 亿参数,视觉编码器约 1.7 亿、音频编码器约 3 亿为可选模块;通过 Matryoshka 表示学习可将输出向量从 768 维截断到 512、256 或 128 维,来源称最高带来约 6 倍存储节省;上下文窗口为 8K token,来源称是 EmbeddingGemma 1 的 4 倍,可处理约 5.5 分钟音频、29 张图像或 58 个视频帧。来源给出的基准数据包括 MTEB Code 从 68.76 提升至 78.68,即在代码任务上提升 9.92 分,并称在 10 亿参数以下的多模态嵌入模型中取得领先成绩。来源还称经量化后在 Google Pixel 11 Pro 上纯文本权重约需 191MB 活跃内存,完整多模态模型约 567MB。权重已在 Hugging Face 与 Kaggle 上线,来源称 Gemini Enterprise Agent Platform Model Garden 支持即将到来,端侧优化版本位于 Hugging Face 上的 LiteRT Community。
对开发者的影响
对开发者而言,这次发布的核心变量是嵌入模型的能力边界从文本扩展到音视频代码,并且权重以 Apache 2.0 发布、可自行微调与再分发,这与只能通过厂商 API 调用的闭源嵌入服务形成不同约束。需要说明的是,Apache 2.0 是许可层面的开放,与权重是否可下载是两件事;本报道中的许可信息来自来源原文,实际使用前应核对模型卡与许可证文件。来源称 EmbeddingGemma 2 与 Gemma 4 共享文本分词器和音频编码器,这意味着把嵌入模型和生成模型放在同一条端侧流程中时,来源预期总内存占用更低,这对离线 RAG 与端侧智能体的部署成本有直接影响。可截断向量维度则是另一个实际变量:向量库的存储与召回质量通常随维度下降而权衡,128 维与 768 维的取舍需要按自身数据规模测量,而不能直接套用来源的宣传口径。来源同时提到可用的推理与部署工具链覆盖 transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama、LMStudio 以及浏览器端的 transformers.js 与 WebGPU,向量存储提到 Qdrant。这些工具名称是来源列出的部署选项,不代表本平台已集成或已验证该模型;该版本目前在 KimiSeek 实时目录中没有精确匹配条目,来源提到的权重下载与端侧部署能力指向 DeepMind 与 Hugging Face 等发布方渠道,而非本平台的 API 供应。
接入与评估建议
建议一:先决定是否需要多模态嵌入,再决定是否需要完整模型。来源报告完整多模态在 Pixel 11 Pro 上量化后约 567MB 活跃内存,纯文本约 191MB,且视觉与音频编码器是可选模块。若你的检索语料只有文本和代码,可以先只加载文本路径;若确有音视频检索需求,才引入对应编码器。可操作的评估标准是:在目标端侧设备或最小可接受的服务器规格上,测出冷启动延迟、常驻内存峰值与每秒嵌入吞吐,确认是否仍满足延迟预算。建议二:对 MRL 截断维度做一次自己的召回实验,而不是直接采用默认 768 维。来源给出 512、256、128 三档以及最高 6 倍存储节省的说法,但检索质量是否可接受取决于你的语料与查询分布。评估标准可设为:在自有标注或人工判定的检索集上,比较 768 维与 256 维、128 维在 Recall@10 与平均查询延迟上的差异,只有当质量下降在你的业务阈值内时才采用更低维度。建议三:如果代码检索是主要场景,可把来源报告的 MTEB Code 提升视为需要复现的对象。评估标准可设为:在你自己的代码库上,用同一套查询分别测 EmbeddingGemma 1 与 EmbeddingGemma 2 的命中率与跨语言检索表现,因为公开基准的绝对分数不能替代私有代码库上的相对比较。以上均为基于来源信息的建议与条件分析,不是来源报告的既成事实。
限制与待确认事项
首先需要明确:EmbeddingGemma 2 目前在 KimiSeek 实时目录中没有精确匹配条目,本平台未上架该模型,来源所述的权重下载与端侧部署能力均指向 DeepMind 与 Hugging Face 等发布方渠道,而非本平台 API 供应。其次,来源中的基准分数(包括 MTEB Code 从 68.76 到 78.68 的提升、10 亿参数以下领先等表述)来自发布方自述,博客未列出完整的评测条件、对比模型清单与评测版本,因此不能视为独立验证结果,实际表现需自行复现。第三,来源给出的内存与存储数据(约 191MB、约 567MB、最高 6 倍节省)基于特定量化方式与 Google Pixel 11 Pro 设备,换到其他硬件或量化配置未必成立。第四,来源称与 Gemma 4 共享分词器与音频编码器带来的联合内存优势,其实际数值未在来源中给出。第五,Gemini Enterprise Agent Platform Model Garden 的支持在来源中标注为“即将到来”,属于计划性表述,不代表当前已可用;本平台亦不提供该模型的 API 接入。价格与可用性会随时间变化,读者应以各发布方当前的定价页与模型卡为准。
原报道配图