GLM 5.3 登陆 Amazon Bedrock:753B MoE 上托管 API,显式提示缓存与跨区域推理成集成重点
据 AWS 官方博客 2026 年 10 月 5 日报道,Z.ai 的 GLM 5.3 已在 Amazon Bedrock 面向符合条件的企业客户开放,可通过 OpenAI 兼容 Responses/Chat Completions 与 Bedrock Invoke/Converse 调用,支持隐式与显式提示缓存、US 与 Global 跨区域推理配置,并提供了用开源渗透测试智能体 Strix 调用它的路径。
发生了什么
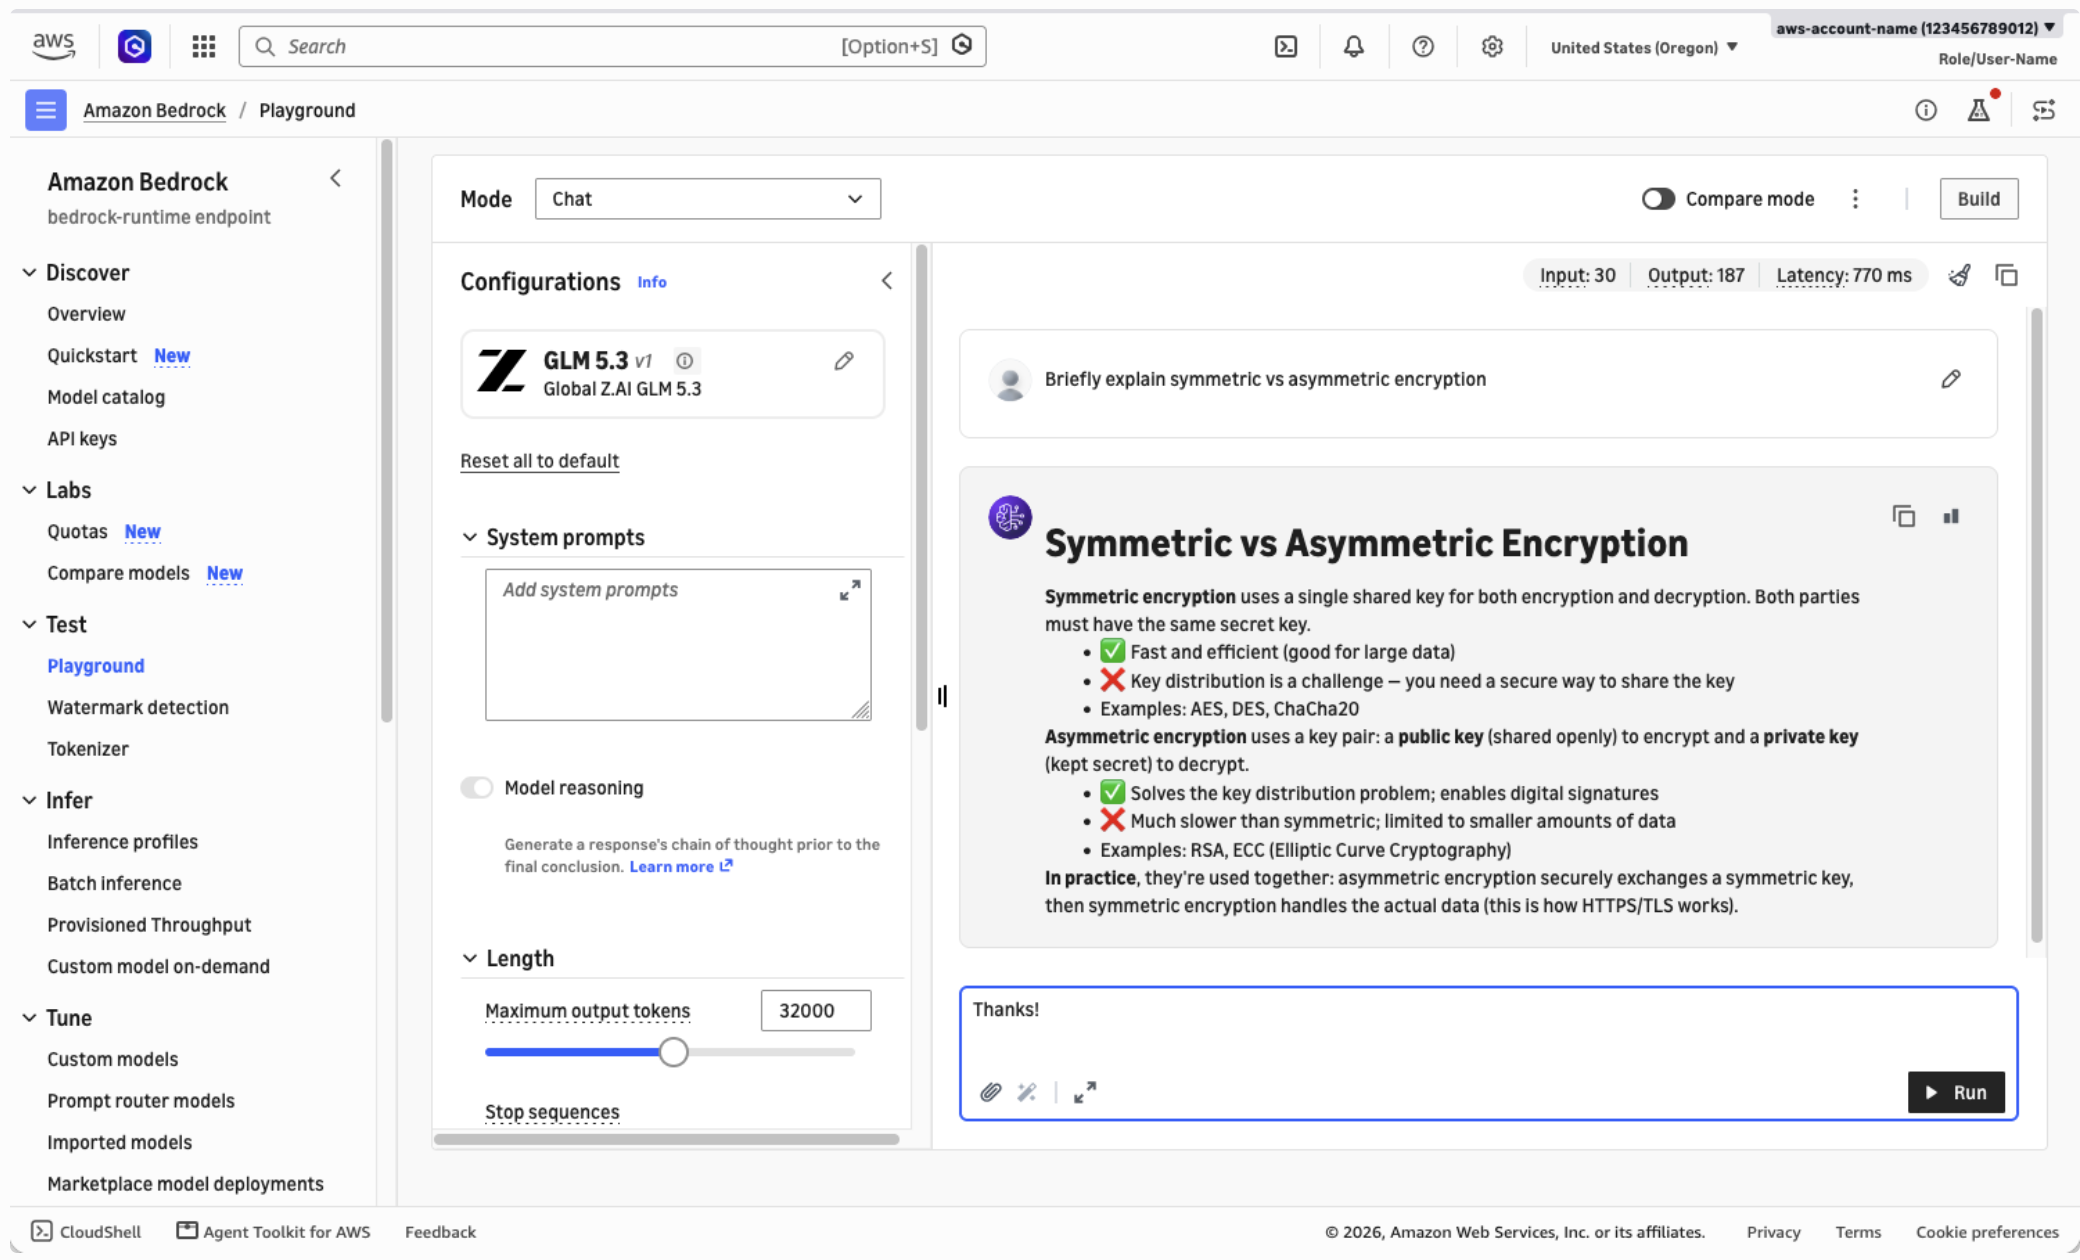
据 AWS 官方博客 2026 年 10 月 5 日报道,Z.ai(智谱 AI)的 GLM 5.3 已在 Amazon Bedrock 上线,面向符合条件的企业客户开放。文中称,按 Hugging Face Hub 发布的信息,GLM 5.3 是 753B 参数的混合专家(MoE)模型,面向编码与长周期智能体任务优化,Z.ai 报告其在安全类任务上表现突出,发布时在 CyberGym 基准测得 84.5 分。相比今年早些时候登陆 Bedrock 的 GLM 5,文中列出三项变化:Z.ai 称其在 DeepSWE、Terminal Bench 3.0、FrontierSWE 等编码基准上具备竞争力,并在内部编码基准上比 GLM 5.2 提升 50%,但未给出与 GLM 5 的直接对比,原因是自 GLM 5.1 起基准本身已被更新;安全能力被描述为“涌现”;Bedrock 集成更完整。接入方式上,模型可通过 bedrock-runtime 端点以 OpenAI 兼容的 Responses 与 Chat Completions API 调用,也支持 Bedrock 的 Invoke 与 Converse;AWS 建议新应用优先用 OpenAI 兼容 API,并优先使用短期凭证而非长期 API key。模型通过 us.zai.glm-5.3 与 global.zai.glm-5.3 两个跨区域推理配置文件提供,并提供 Flex、Priority、Standard 三档服务层级。
对开发者的影响
对正在评估中国模型托管路径的开发者,这一事件的实质变化不在“模型更强”,而在调用面与成本控制手段的补齐。第一,Bedrock 同时提供 OpenAI 兼容接口和原生 Invoke/Converse,意味着已有的 OpenAI SDK 代码改动集中在 base_url、鉴权方式(用 aws-bedrock-token-generator 从 AWS CLI 凭证换取短期令牌)与模型标识,而不是重写调用层;这对已有多套 OpenAI 兼容适配的团队,迁移成本主要在凭证与路由,而非业务逻辑。第二,显式提示缓存被 AWS 标为“推荐”,对每轮重发系统提示、工具定义或仓库文件的智能体负载直接关系到输入 token 成本与首字延迟,缓存命中率因此变成一个可观测的工程指标。第三,跨区域推理配置把“请求发到哪个区域”和“实际在哪处理”解耦,企业客户需要重新审视数据驻留与合规口径,而不是假设请求就地执行。第四,Strix 文档目前把 GLM 5.3 作为默认模型,且可指向 Bedrock,这让安全测试这类高敏感负载的推理落在自有 AWS 账号管控内,对安全团队是有意义的选项,但涉及授权范围与合规判断,不能简单等同于“开箱即用”。需要注意,上述能力描述均来自 AWS 单方博客与 Z.ai 的自报基准,尚无独立复现验证。
接入与评估建议
建议按以下条件化规则做评估,这些是基于来源的判断而非已证实结论。第一,是否改用 OpenAI 兼容接口:如果现有应用已基于 OpenAI SDK,且需要显式缓存的完整功能集,按 AWS 说法应优先选 OpenAI 兼容的 Responses API;如果现有代码深度绑定 Bedrock Converse 或需要与其它 Bedrock 模型共用调用层,则保留原生接口更省改动。前提是账号已具备 bedrock:InvokeModel、bedrock:InvokeModelWithResponseStream、bedrock:CallWithBearerToken 权限。可测量的评估标准是在同一长系统提示下跑两轮对话,检查响应中 input_tokens_details.cached_tokens 是否非零,并对比两次的输入 token 计费与首字延迟差异。第二,是否启用显式缓存:若工作负载每轮重发大段静态上下文(系统提示、工具定义、仓库片段),按来源建议切换到 prompt_cache_options 的 explicit 模式并打 prompt_cache_breakpoint;若上下文短或变化频繁,隐式缓存即可,不值得增加标记维护成本。前提是每个断点至少 1,024 个 token 才具备缓存资格,短提示打点无效。可测量标准是同一负载下缓存命中 token 占比与端到端延迟的下降幅度,并确认断点切分不破坏语义边界。第三,选哪个跨区域配置文件:面向美国用户或已有 us 区域合规要求的团队评估 us.zai.glm-5.3,需要更广覆盖时评估 global.zai.glm-5.3,选择依据是数据驻留要求与延迟实测,而非默认取“全球”。可测量标准是从目标源区域发起请求的 P50/P95 延迟,以及合规评审对处理区域的书面结论。第四,服务层级:对批处理、离线分析类不敏感任务评估 Flex 以优化成本,对交互式编码助手等延迟敏感请求评估 Priority,Standard 作为默认基线。前提是层级选择会改变单价,务必在控制台核对当前计费。无论如何,先用自有代码库与真实智能体轨迹做小规模对照,而不是直接替换生产默认模型。
限制与待确认事项
GLM 5.3 这一版本目前未出现在 KimiSeek 的实时目录中,本文提到的 Bedrock 可用性、模型标识与计费口径均指 AWS 与 Z.ai 一方,不代表 KimiSeek 上的供应情况。KimiSeek 目录中另有 GLM-5.3、GLM-5.3 Flash 与 GLM-5.2 等条目,它们是不同版本或不同供应渠道,不能据此推断本文所述 Bedrock 版本已在 KimiSeek 上线。来源中的性能说法,包括 CyberGym 84.5、内部编码基准较 GLM 5.2 提升 50% 以及 DeepSWE、Terminal Bench 3.0、FrontierSWE 的“竞争力”表述,均为 Z.ai 自报或 AWS 转述,未见独立复现,基准版本也已随 GLM 5.1 起更新,横向对比需谨慎。AWS 明确说明 GLM 5.3 面向“符合条件的企业客户”,普通账号是否可直接开通、各区域是否全部可用,来源未说明。原文还提到 LiteLLM 当时尚不能解析 bedrock/global.zai.glm-5.3,需显式指定 Converse 路由与推理配置文件 ARN,这是当时的已知限制,后续是否修复未知。Strix 以 GLM 5.3 为默认模型一说来自“截至本文撰写时”的文档描述,可能已变动。价格与层级单价会随时间调整,请以 AWS 与 KimiSeek 的实时定价页面为准。安全测试示例仅适用于自有或获书面授权的应用,来源内容在 AWS Continuum 段落处被截断。
原报道配图