JetBrains 开源 Mellum2.1:12B MoE 编码智能体模型,Apache 2.0 权重与量化版本齐备
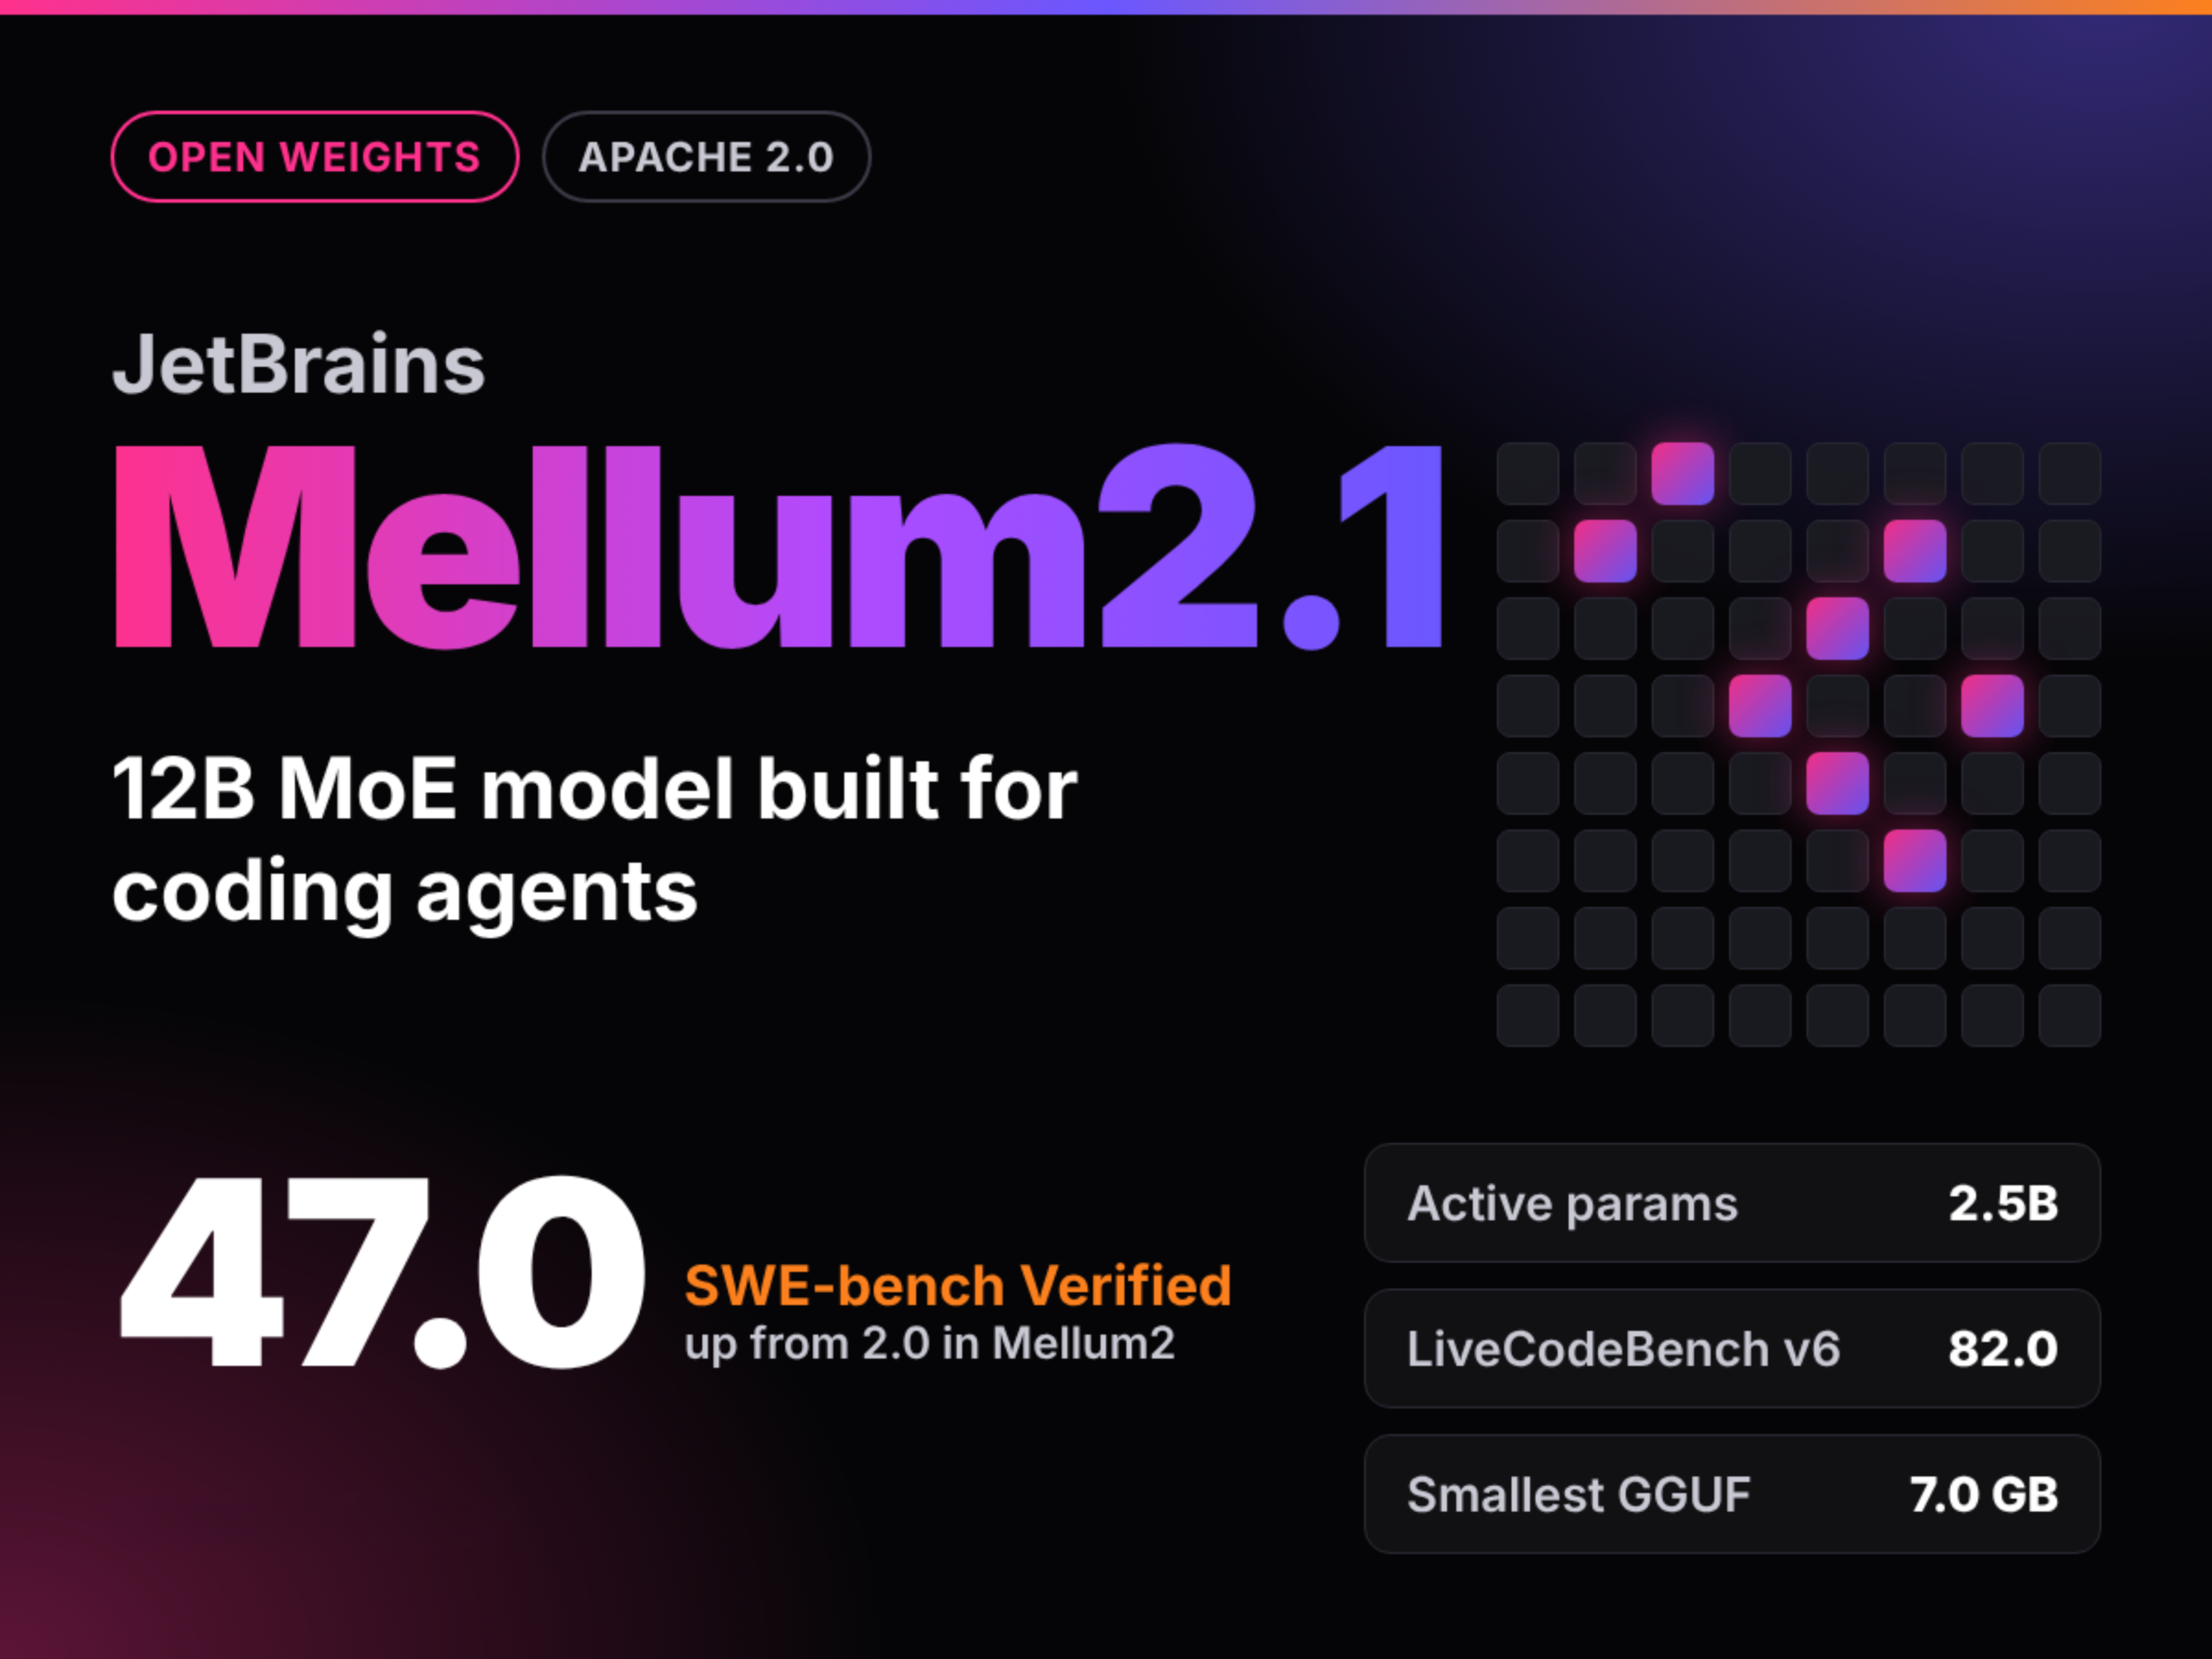
据 MarkTechPost 2026 年 10 月 8 日报道,JetBrains 以 Apache 2.0 协议发布 Mellum2.1,即 Mellum2.1-12B-A2.5B-Thinking:12B 总参数、每 token 激活 2.5B 的 MoE 思考模型,架构与上一代相同,提升主要来自真实代码仓库中的强化学习,报告称 SWE-bench Verified 由 2.0 升至 47.0。
发生了什么
据 MarkTechPost 2026 年 10 月 8 日报道,JetBrains 发布 Mellum2.1,检查点名称为 Mellum2.1-12B-A2.5B-Thinking,以 Apache 2.0 协议在 Hugging Face 发布权重。它是 12B 总参数、每 token 激活 2.5B 参数的专家混合推理模型,28 层、64 个专家、每 token 激活 8 个,采用 GQA(32 查询头、4 KV 头),每 4 层中 3 层使用 1024 token 滑动窗口,上下文 131072 token,词表 98304,权重为 bfloat16。报道称架构相较 2026 年 6 月开源的 Mellum2 Thinking 未变,升级几乎全部来自后训练:RL 成为训练主体,增加数学、竞赛编程、科学、工具调用与软件工程任务,并在真实代码仓库中以 shell 与文件编辑工具训练、测试通过给奖励。报道称 JetBrains 自测下 SWE-bench Verified 从 2.0 升至 47.0,SWE-bench Pro 从 0.0 升至 28.0,Terminal-Bench 2.1 从 0.6 升至 17.4,LiveCodeBench v6 为 82.0、BFCL v4 为 62.3,HarmBench 从 21.5 降至 8.5;Qwen3.5-9B 在 SWE-bench Verified(50.0)、SWE-bench Pro(38.0)、GPQA Diamond(77.8)与 AIME 25/26(86.7)上仍领先。
对开发者的影响
这条发布对自托管编码智能体的意义集中在三点,且均依赖报道口径而非独立复现。第一,模型以 Apache 2.0 协议开放权重,属于许可明确的开放权重发布,而非仅可下载的权重;但报道中所有基准分数均由 JetBrains 自报,Qwen 官方模型卡对同一模型的 LiveCodeBench v6 与 GPQA Diamond 数值与 JetBrains 测评流程差异明显,说明分数对评测框架敏感,不能直接当作跨厂商可比结论。第二,2.5B 激活参数加上 131072 token 上下文与 GGUF 量化,使本地子智能体在消费级或单卡环境具备可行性:报道列出 BF16 24.3 GB、Q8_0 12.9 GB、Q4_K_M 8.1 GB(首 token 匹配率 88.0%)、MXFP4_MOE 7.0 GB(85.6%)等版本。开发者需要关注的是量化后能力衰减是否落在自己任务的容差内,而非单一文件体积。第三,报道称单张 H200 高负载下吞吐接近 Qwen3.5-9B 的两倍,MTP 在单请求场景约 1.6 倍加速,但用于 vLLM 投机解码的 MTP 头标注为即将推出,意味着当前部署无法直接利用该加速。对使用编码智能体的团队,这更像是一个低成本执行单元的候选,而不是通用推理主力替代品:报告显示其在 Terminal-Bench 2.1 与知识类基准上落后。
接入与评估建议
建议按任务分层验证,而不是整栈替换。决策一:若工作负载是高并发、短步骤的代码补全或子智能体执行单元,可优先评估 12B/2.5B 激活的 MoE 部署,前提是具备单卡以上显存与 vLLM 或 SGLang 环境,报道给出的启动方式是 vLLM 配 --reasoning-parser qwen3,工具调用需加 --enable-auto-tool-choice --tool-call-parser hermes,采样参数建议 temperature 0.6、top_p 0.95、top_k 20;衡量指标应是同等硬件下每 token 吞吐与单位任务成本,而非只看基准分。决策二:若工作负载是长链路的仓库级修复,建议先用自有仓库做小样本对照,与 Qwen3.5-9B 一类模型比较任务通过率与失败模式,因为报道自报 SWE-bench Verified 47.0 低于 Qwen3.5-9B 的 50.0,Terminal-Bench 2.1 差距更明显,这里的条件是企业已有可自动判定的测试集;衡量指标是端到端任务通过率与平均步数。决策三:本地或离线场景可先试 Q4_K_M 与 MXFP4_MOE 量化版本,前提是任务对首 token 行为偏差不敏感,衡量指标是量化版与 BF16 参考版在自有提示集上的首 token 匹配率与实际正确率落差。另需注意,报道描述的可用性指供应商发布的权重与推理框架支持,接入方式以各框架文档为准。
限制与待确认事项
关键限制需明确:Mellum2.1 没有出现在 KimiSeek 的实时模型目录中,该版本目前未在 KimiSeek 上架,报道中提到的权重、GGUF 与 vLLM/SGLang 部署方式均指 JetBrains 方面的发布,不代表本站可用。所有性能数字来自 JetBrains 自报或其统一评测流程,包括 SWE-bench、Terminal-Bench、LiveCodeBench 与 BFCL,未经独立复现;报道自身即指出 Qwen 官方模型卡与 JetBrains 测评在同一模型上给出不同数值,因此横向对比结论需谨慎。量化版本的首 token 匹配率并不等同于任务正确率,报道中的 GGUF 列表与“GGUF 仍在制作中”的说明存在口径差异,实际可用文件与质量需自行核对。MTP 头标注为即将推出,vLLM 投机解码加速当前尚不可用。此外,具体调用价格与计费方式请以供应商定价页面为准,本文不引用具体数值。