九章云极开源 GLM-5.3 推测解码方案 Alaya-DFlash2,称 32k 上下文解码提速 3.41 倍
据 InfoQ 2026 年 10 月 20 日报道,九章云极发布面向 GLM-5.3 的推测解码加速方案 Alaya-DFlash2,含并行起草草稿模型与路径选择机制,并公开权重。厂商评测称 8×H200、TP=8 下单并发解码速度为原生自回归的 3.41 倍,1k 至 32k 低熵上下文接受长度均高于两个对比方案。这些数字与对比均为厂商自测评测,尚待第三方复现。
发生了什么
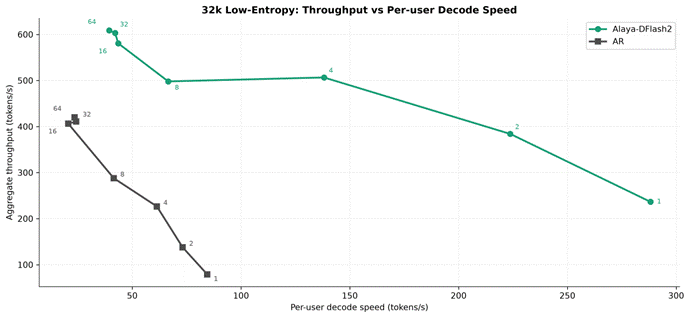
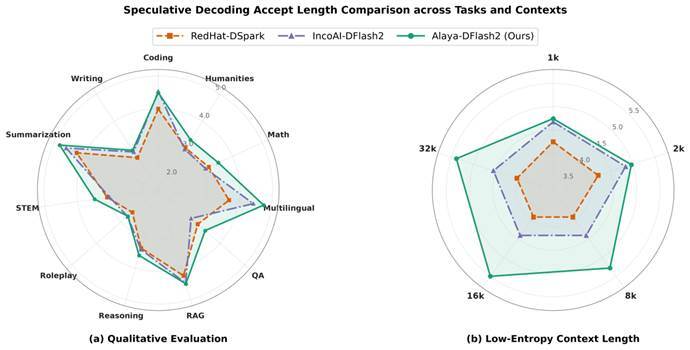
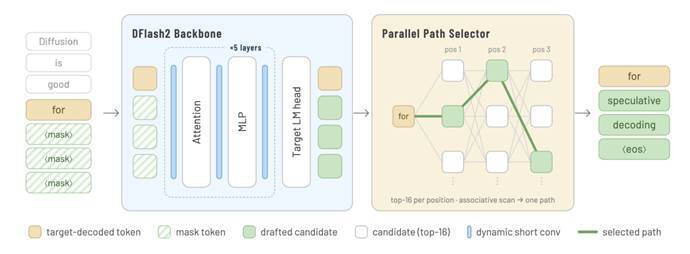
据 InfoQ 2026 年 10 月 20 日报道,九章云极推出面向 GLM-5.3 的推测解码加速方案 Alaya-DFlash2,由一个可并行起草的草稿模型和一套路径选择机制组成,权重以 AlayaNeW/GLM-5.3-DFlash2 的名义公开,报道未说明具体开源许可证条款。报道称该方案基于九章云极 AlayaNeW 智算引擎围绕 GLM-5.3 训练配套草稿模型。评测方面,报道给出 8×H200、TP=8 环境下的数据:单并发解码速度约 288.2 tokens/s,原生自回归约 84.5 tokens/s,为 3.41 倍;对应总输出吞吐从 78.95 升至 236.47 tokens/s。并发上升后优势收窄,4 并发吞吐为原生自回归的 2.24 倍,64 并发吞吐 608.71 tokens/s,较原生自回归的 420.13 tokens/s 提升 44.9%。报道还列出低熵上下文接受长度:1k、2k、8k、16k、32k 分别为 4.74、4.97、5.28、5.50、5.39,均高于其参评的 IncoAI-DFlash2 与 RedHat-DSpark;并称 11 类任务中 9 类接受长度领先,代码与角色扮演两类与 IncoAI-DFlash2 接近。
对开发者的影响
推测解码对开发者的实际意义在于它改变的是相同硬件上的生成成本结构,而不是模型能力本身。按报道口径,长上下文场景下草稿接受长度维持在 5 左右,意味着一次主模型前向可验证并通过约 5 个候选 token,减少主模型反复解码的轮次,直接压缩首字之后的持续输出等待。对自建 GLM-5.3 推理服务的团队,这相当于在不更换主模型、不改变输出分布的前提下换取解码吞吐,代价是额外加载一份草稿模型权重与相应的显存和调度开销。报道同时显示增益随并发变化:单并发速度提升最大,64 并发时总吞吐提升收窄到 44.9%,说明该方案的收益更多体现在低并发交互场景,高并发服务下单位吞吐增量相对有限。需要注意的是,所有数字均来自厂商自测,测试环境固定为 TP=8、8×H200,接受长度依赖具体数据分布,低熵上下文之外的分布可能表现不同;权重公开不等于许可证条款明确,商用前仍需核对仓库中的许可信息。
接入与评估建议
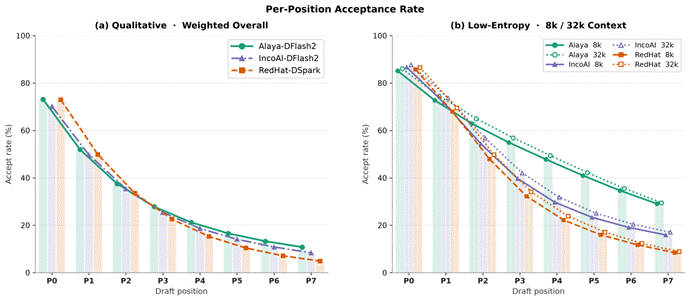
建议按以下条件做取舍,而非直接照搬评测结论。第一项决策是是否引入该草稿模型。若推理负载以长文档问答、RAG 总结等长上下文、低到中并发为主,报道给出的 16k 至 32k 接受长度高于 5 的数据支持做一次真实流量对照测试;若负载以高并发短请求为主,报道中 64 并发吞吐仅提升 44.9%,需先测算草稿模型带来的额外显存占用与调度成本是否值得。评估标准可设为:在自有 32k 长度样本上测量实测接受长度与 token 间延迟,若接受长度明显低于报道水平或显存增量导致并发上限下降,则不引入。第二项决策是草稿位置数与验证批次的配置。报道显示草稿后段接受率仍然可观(32k 下第 5 个位置 49.43%、第 8 个位置 29.51%),这支持将验证深度调得比默认更深;但这一收益成立的前提是后端接受率在自有数据上同样保持,若在代码、角色扮演等报道中未取得领先的任务类型上接受率快速衰减,增加草稿长度只会浪费算力。评估标准可设为:按位置统计通过率,找出接受率跌破设定阈值的位置并据此截断草稿长度。以上均为基于报道数据的条件性建议,不是厂商给出的部署结论。
限制与待确认事项
报道全部性能数据来自九章云极自测,未提供第三方复现,也未披露测试数据集、提示模板与解码参数,接受长度高度依赖数据分布,换到自有流量上未必复现。评测环境固定为 8×H200、TP=8,其他硬件与并行配置下的表现未知。报道所称开源只给出权重地址,未说明许可证类型,权重可用不等于许可条款允许任意商用或再分发,需以仓库声明为准。此外,Alaya-DFlash2 是面向 GLM-5.3 的独立草稿模型方案,与主模型本身是两回事;GLM-5.3 在 KimiSeek 当前目录中确有对应条目,但 Alaya-DFlash2 这一加速方案本身并未作为可调用模型在 KimiSeek 上架,相关可用性以厂商与权重仓库为准。
原报道配图