Kimi K3.1 Pro Highspeed 上线 Bedrock:默认推理强度为 max,Flex 档与显式缓存各有边界
AWS 在 2026 年 11 月 10 日的博客中称,Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上线,沿用 K3 的端点与 API,Moonshot AI 自报其输出速度是 K3.1 Pro 的 2–3 倍;默认推理强度为 max、Flex 档的延迟代价、显式缓存在 Converse 上不可用,是接入前要定的三件事。
发生了什么
AWS 在 2026 年 11 月 10 日的机器学习博客中宣布,Moonshot AI 的 Kimi K3.1 Pro Highspeed 已在 Amazon Bedrock 上线。文章把它描述为 Kimi K3 的后训练版本:沿用同一 3T 级开放权重架构与 100 万 token 上下文窗口,用显著更多的后训练算力训练;据 Moonshot AI 称,这部分训练面向长周期智能体任务、旨在减少事实性错误,并提升财务建模、办公文档,以及面向游戏引擎、3D 场景与 CAD 脚本的编程能力。它的输出 token 生成速率更高,Moonshot AI 自报其速度为 Kimi K3.1 Pro 的 2–3 倍。在 Bedrock 上,它沿用 Kimi K3 的端点、API 与功能,已在用 K3 的应用只需更改模型 ID;支持工具调用、结构化输出、可配置推理、图像输入与流式输出,可通过 global、us、in 三个跨区域推理配置文件访问,区域数据驻留要求是选配置文件的依据。AWS 称数据在其数据边界内处理,不与 Moonshot AI 共享、不用于训练模型,推理请求始终启用零数据保留,操作员在推理期间无法查看提示词与补全结果。K3.1 系列此前已有报道,这次新增的是 Bedrock 托管渠道以及随之确定的推理与计费选项。
对开发者的影响
对接入的实际影响集中在接口形态与默认值,而不是模型能力本身。已在用 OpenAI SDK 的团队把 base_url 指向 Bedrock 运行时端点、改模型名即可,但认证换成由 AWS 凭证生成的短期 bearer token;IAM 需要 InvokeModel 与 InvokeModelWithResponseStream 权限,走 bearer token 还要 CallWithBearerToken。Bedrock 同时提供 OpenAI 兼容的 Chat Completions 与 Responses,以及自家的 Converse 与 Invoke,AWS 推荐前者。第二个变化是推理默认拉满:模型总是先推理再回答,未设置强度时取 max,在分类、字段抽取、短问答这类答案空间小的任务上,这会直接抬高延迟与输出 token;解析 Converse 返回时也要挑文本块,因为响应可能先给一个推理块。第三处是分层:AWS 称 Flex 以 Standard 价格的一半服务,代价是响应时间可能更长,且按需配额在 Standard、Priority、Flex 三档之间共享,把流量挪到 Flex 不会凭空多出配额;层级按请求指定,同一应用可以混用。第四处是缓存的接口边界:显式提示缓存适用于 Chat Completions、Responses 与 Invoke,不适用于 Converse;断点之前至少要有 256 token 的稳定内容,缓存内容至少保留 30 分钟,写入按高于标准输入的费率计费,读取按折扣费率且不计入每分钟输入 token 配额。对每轮重发系统指令、工具定义与仓库约定的智能体和编程助手,缓存命中往往比单价更影响账单。报道还解释了输出速度为何在编程智能体里更关键:读文件、规划改动、编辑代码、跑测试、修失败是一串串行调用,每步都要等上一步结束,单位时间输出更多 token 会缩短整个循环。这些都是渠道侧的结构性变化,不构成对模型质量的独立验证。
接入与评估建议
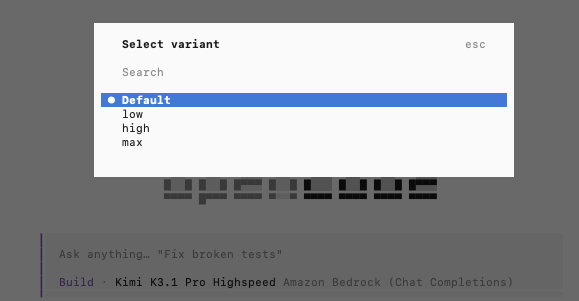
以下为基于该报道的条件性分析与建议,属于推荐而非已核实的事实。 决策一,把推理强度显式写进配置。报道称不设置 reasoning_effort 时默认 max,可选 low、high、max,Responses 上对应 reasoning.effort 的同一设置。若你的负载是分类、字段抽取、短问答或模板化改写,这类任务的答案空间小,建议按任务类型固定为 low 或 high,只在确需多步推理的链路上保留 max。前提是你手里有分档后的自有评测结果,而不是凭直觉调低;链路对输出格式有硬约束时,还要确认降档不会让结构化输出的字段变少。可测标准:在同一套自有题目上比较 low 与 max 的通过率与输出 token 中位数,若通过率下降落在可接受区间而输出 token 明显减少,就把档位写进配置而不再依赖默认值。 决策二,按请求选择服务层级,并核对实际生效的层级。AWS 称 Flex 延迟可能更长但价格更低,层级可按请求设置、三档共享配额。若你的任务是离线评测、批量摘要或智能体中的后台步骤,对单次响应时间不敏感,可以把一小部分流量放到 Flex,把面向用户的同步请求留在 Standard 或 Priority。前提是用 CloudWatch 的 ServiceTier 与 ResolvedServiceTier 维度确认请求实际由哪一档服务,因为请求 Flex 与由 Flex 服务是两件事,而混用层级会同时改变尾延迟与配额消耗。可测标准:同一批任务在 Flex 与 Standard 下的 p95 延迟与每千次任务成本,只有成本改善且尾延迟仍在你设定的超时预算内,才扩大比例。 决策三,把缓存可用性当成接口选型条件,而不是事后优化项。显式缓存在 Converse 上不可用,断点前需至少 256 token 稳定内容,缓存至少保留 30 分钟。若你的服务已经建在 Converse 上,且上下文含大段稳定前缀(系统指令、工具定义、仓库约定),就要在切到 Chat Completions 或 Responses 换取显式缓存、与接受仅靠自动缓存之间做选择:前者能提高命中率,代价是改调用路径,并接受缓存写入按更高费率计费。可测标准:先读回用量中的缓存 token 数确认命中大于零,再比较开启前后的输入成本与首 token 延迟,同时确认断点位置微调后命中率不会明显塌掉。 另有一项适合在架构评审阶段定下:global 配置文件每 token 成本低于地理范围配置文件,但有数据驻留要求时只能选 us 或 in,上线后再改会牵动部署拓扑。若已在 Bedrock 上用 Kimi K3 跑业务,最小验证是保留一组任务并行打 K3 与 Highspeed,比较单任务完成时间与失败重试次数,而不是只看首包速度。
限制与待确认事项
两点不确定性需要保留。其一,2–3 倍是 Moonshot AI 的自报速度,AWS 博客没有给出基准、测量方式与并发条件,实际差距取决于输出长度与所用层级,不能当作已独立复现的结论。其二,文中“3T 级开放权重架构”是对架构的描述,而 Bedrock 交付的是托管推理服务:权重能否下载、以什么许可发布,都无法由这句话推出,需要查 Moonshot AI 的官方发布与许可文本;即便权重可下载,开放权重也不等于开源许可。还有一处容易混淆:按原文,更多后训练算力、减少事实性错误以及财务建模、办公文档、游戏引擎、3D 与 CAD 脚本等专业能力提升,是相对 Kimi K3 的描述;Highspeed 与非 Highspeed 的 K3.1 Pro 之间,本文给出的差别主要是输出 token 生成速率,文章没有提供两者的逐项能力对比,也没有给出 Highspeed 的独立评测数据。缓存“至少保留 30 分钟”只给了下限没给上限,Flex 的延迟代价也只有定性描述。支持区域、配额与价格应以 Bedrock 的模型卡、区域可用性页与定价页为准,这些内容会变动;站内目录本次核对时已有同名条目,其价格与额度请看站内定价页,但目录收录与 Bedrock 上线是两件独立的事,前者不构成对后者的验证。
原报道配图