Liquid AI 发布 LFM3:六个 2B 级模型共用一个骨干,开放权重下的端侧取舍
据 Liquid AI 2026 年 10 月 27 日博客,LFM3 把文本、视觉、音频、全模态与决策模型统一到 1.7B 级共享骨干,宣称全部开放权重、可在单 GPU 微调;开发者需重新权衡全模态单模型与专用小模型两条路线。

发生了什么
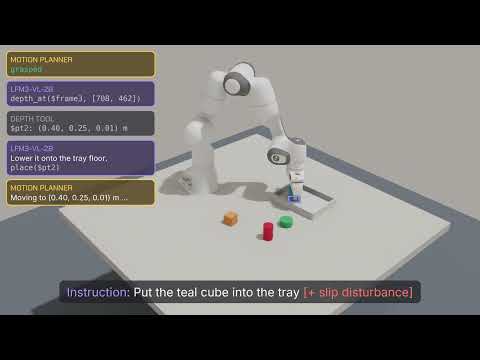
Liquid AI 于 2026 年 10 月 27 日在官方博客发布 LFM3 系列。按博客说法,该系列含六个 2B 级模型:LFM3-1.7B(文本)、LFM3-VL-2B(文本、图像、视频输入)、LFM3-Audio-2B(文本与音频输入,文本与语音输出)、LFM3-Omni-2B(全模态输入、文本与语音输出),以及基于视觉与全模态分支的决策模型 d1-2B 和 d1-omni-2B;另有 LFM3-1.7B-Base 供自行后训练。厂商称所有模型均从同一骨干分支而来,可从 Hugging Face 获取,并在单块 GPU 上微调,文本模型 4-bit 精度下约占 1 GB,骨干上下文窗口扩展到 256K token。博客还给出若干对比数字,例如 LFM3-1.7B 在 WebArena-Verified 得 38.42、前代 LFM2.5-2.6B 为 3.02;LFM3-VL-2B 在 62 个视觉基准上的平均分从 57.6 升至 71.4。厂商同时声称,按参数计算,LFM3-1.7B 在边缘设备短提示上与 LFM2-1.2B 相当,而在上下文含 8K token 时约快 25%。上述数字均为厂商自报,未见第三方复现。
对开发者的影响
这次发布对开发者的核心影响不是又多了一个模型,而是选型颗粒度的变化:过去要在设备端跑多模态,往往得把 ASR、视觉语言模型和 TTS 串成流水线,现在厂商提供了一个全模态单模型选项;但它同时保留单模态模型,说明多模态合并未必在所有场景都划算。推理侧约束也随之变化:视觉模型要求 transformers 5.21.0 以上,音频和全模态模型要求 5.20.2 以上,d1 要求 5.19 以上,且多数示例依赖 trust_remote_code,升级框架、审查自定义远程代码会成为接入前置工作。端侧内存方面,文本模型 4-bit 下约 1 GB 是可规划的数字,但博客未给出视觉、音频模型的显存或内存占用,视频输入与语音流式输出的实际资源开销需要自行实测。博客强调新视觉编码器与 LiquidCodec 的效率,宣称音频首 token 可低至 50 ms、单 CPU 线程约 87 倍实时合成语音,这类指标高度依赖硬件与输入长度,不宜直接当作线上容量规划依据。厂商还给出微调 notebook,覆盖 SFT、DPO、GRPO 与持续预训练,对需要私有术语与工具调用的团队,这是比基准分数更值得先跑通的部分。
接入与评估建议
建议一(条件性分析):若端侧应用需要在同一请求里同时处理语音与画面,先在全模态单模型与“音频模型 + 视觉模型”组合之间做对照。触发条件是单请求内确实存在跨模态关联,例如对着一帧画面口述提问;若音视频在业务上互不相关,专用模型的可控性通常更好。可测标准:在同一批真实样本上对比首 token 延迟、端到端完成时间与内存峰值,并检查全模态模型在纯文本或纯语音子任务上相对专用模型是否出现明显退化。建议二(条件性分析):若你已有基于 LFM2.5 系列的推理服务,不要仅凭 WebArena-Verified 38.42 对 3.02 这类厂商数字直接切换,而应先用自有智能体轨迹做 A/B。触发条件是工作负载以长上下文工具调用为主;博客称升级收益主要体现在智能体任务与长上下文,而对短提示的比较是按参数计算的,并非绝对性能等同。可测标准:在自建任务集上记录工具调用成功率、格式合规率与每千 token 的实际耗时,而不是只看公开榜单。建议三(条件性分析):若你对结构化判断比对文本生成更感兴趣,可评估 d1-2B 是否替代“小语言模型 + 解析后处理”的方案。前提是业务能接受校准概率输出而非自然语言;若下游需要可解释文本,d1 路线不合适。可测标准:用带标注的历史工单或票据计算各字段的校准误差,并比较一次前向的处理时延与现有流水线。
限制与待确认事项
来源为厂商博客,基准分数、速度与内存数字均为自报,未提供独立复现或完整评测方法,博客内部的横比口径(如部分编码器对比使用统一的 LFM2.5-230M 语言骨干)也需自行核对。博客称所有 LFM3 模型为开放权重,但正文未说明具体许可证条款;开放权重不等于开源许可,商用、再分发与微调后发布的权利须以模型卡和许可文本为准,不能从“权重可下载”推断。LFM3 各模型目前在 KimiSeek 的在线目录中没有对应条目,该版本当前未在 KimiSeek 上架;博客也没有提供托管 API,所称可用性指 Hugging Face 上的权重下载与本地运行。若后续出现托管服务或另行定价,应以官方页面为准。此外示例依赖 trust_remote_code,生产环境需自行审计远程代码;视频输入、语音流式、多语言语音翻译等能力的实际效果与资源占用,博客只给出少量示例,需自行验证。
原报道配图