Meta 开放 Muse Spark Open 权重:8160 亿参数 MoE 可在两台 Mac Studio 本地跑,编程基准低于 GLM 5.3 max 与 Kimi K3 max
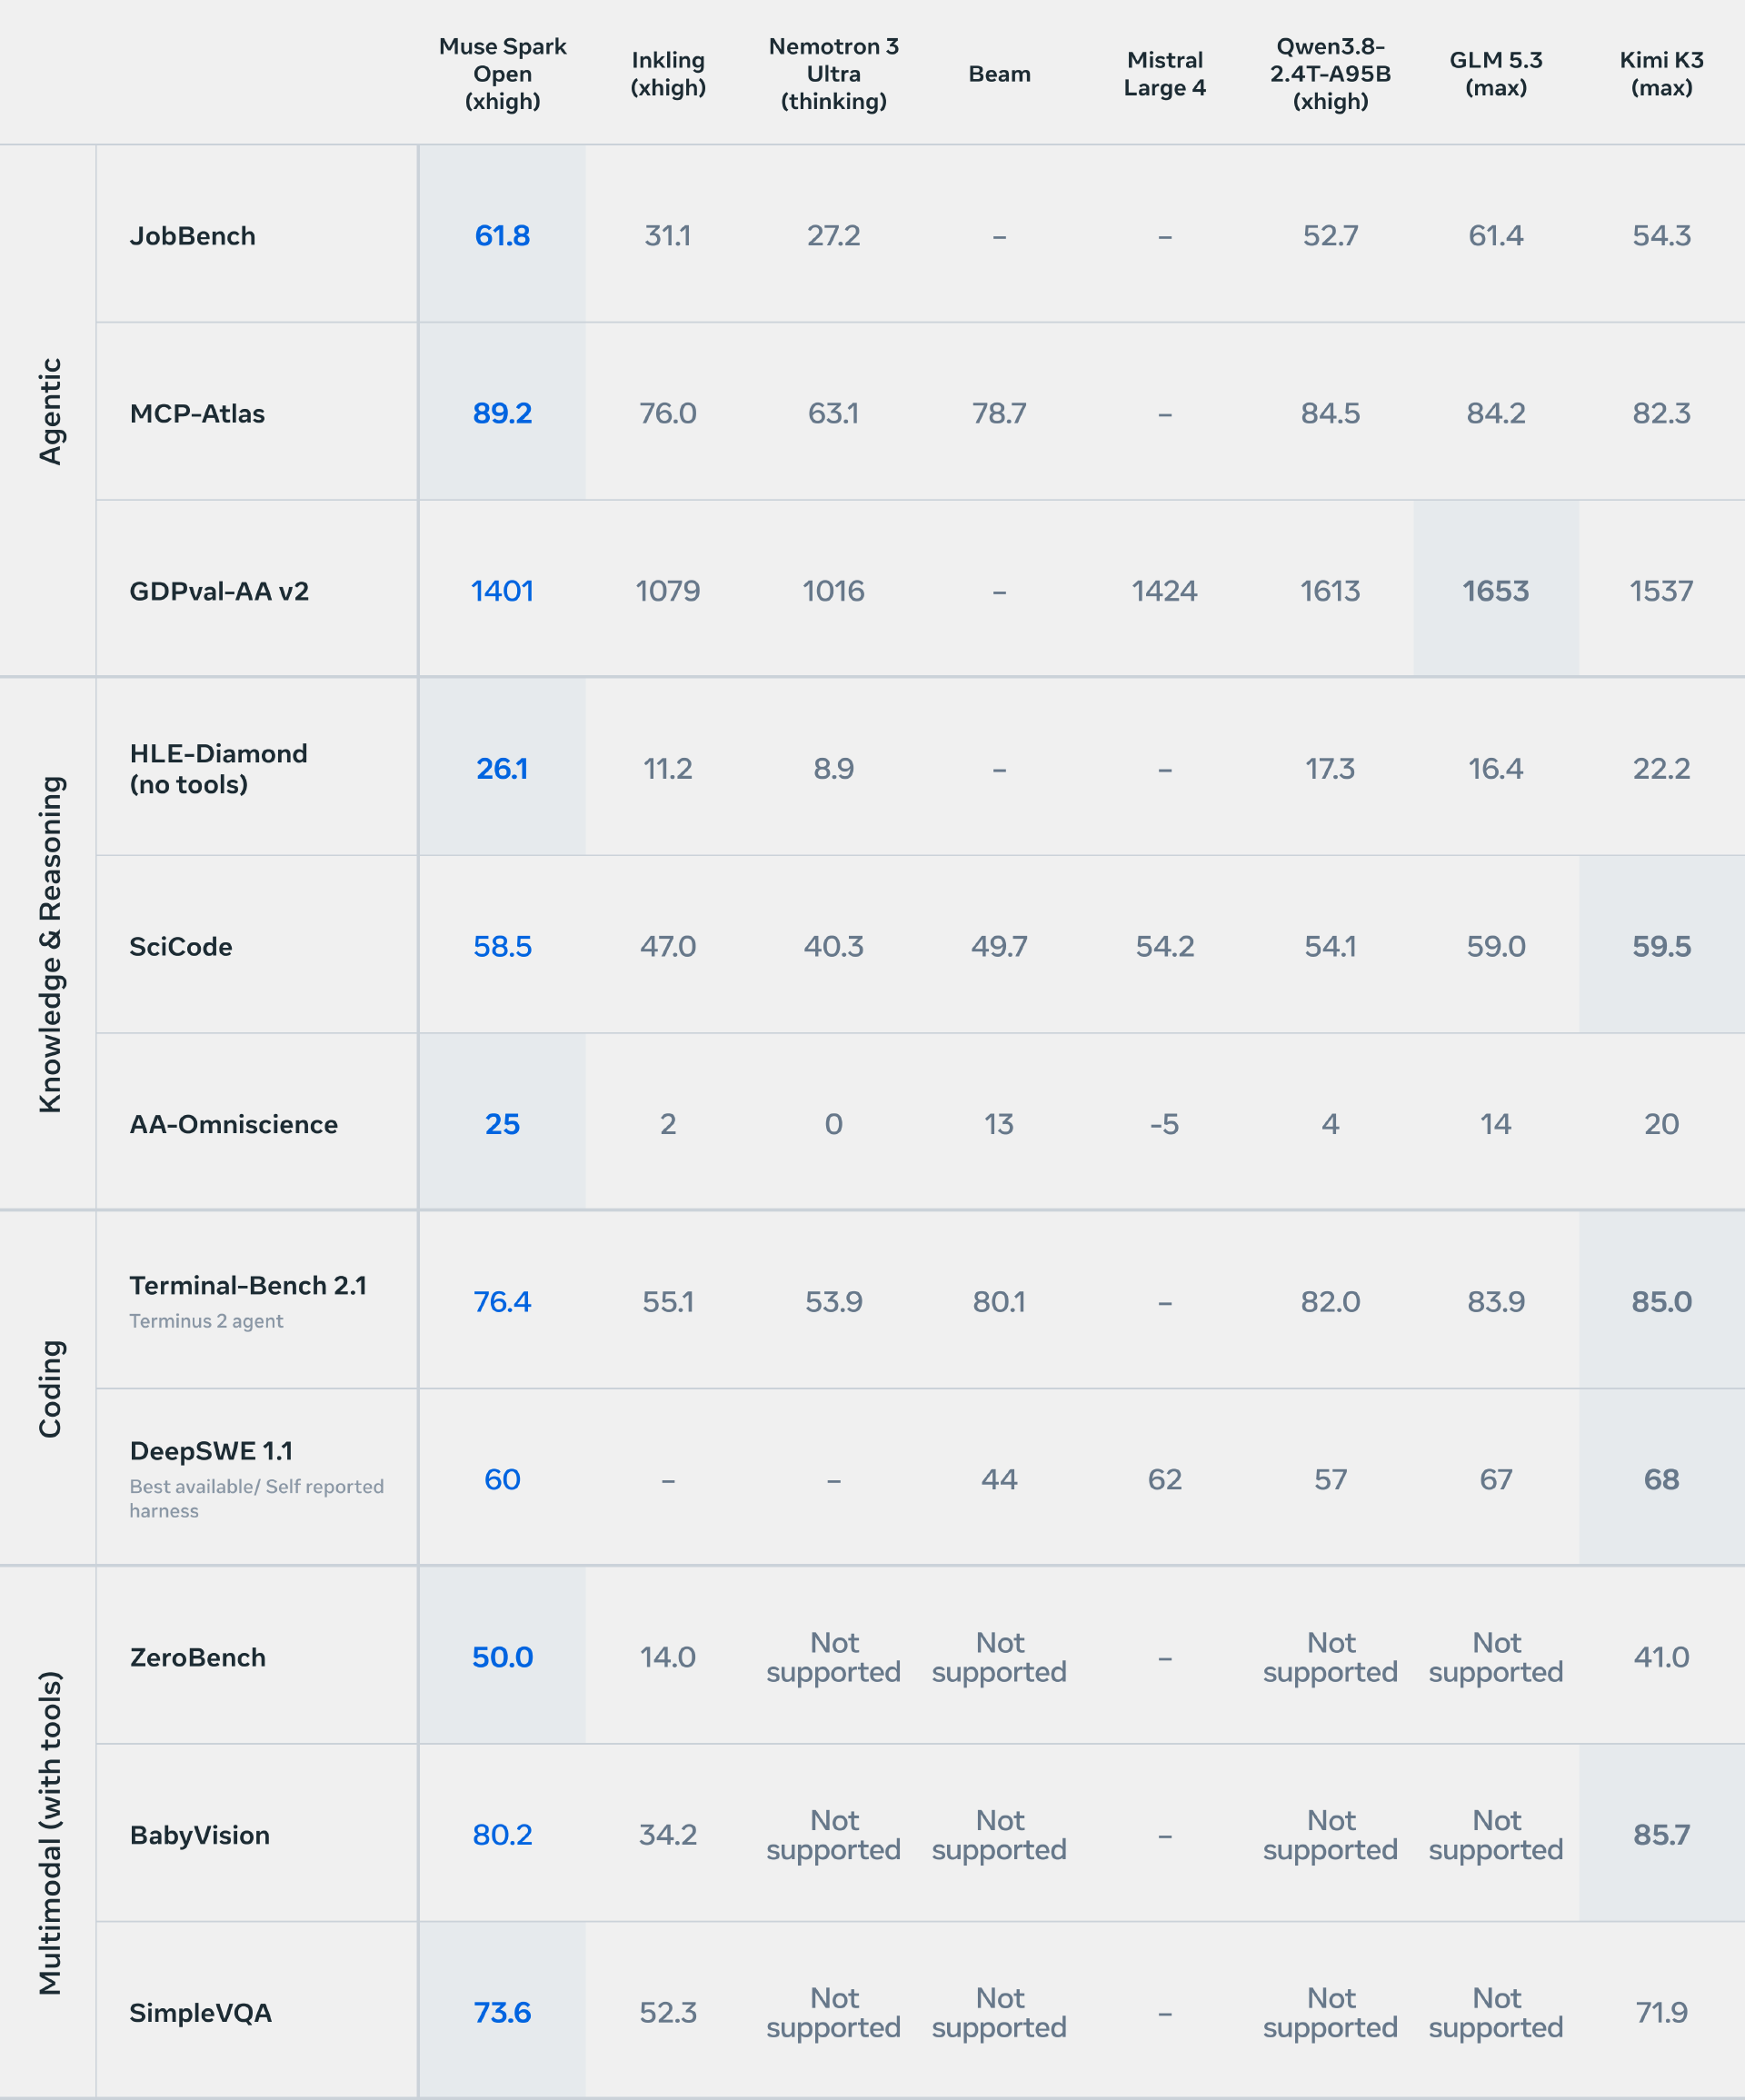
据 InfoQ 2026 年 10 月 18 日报道,Meta 于 10 月 15 日开放 Muse Spark Open 权重:8160 亿总参数、约 420 亿激活的稀疏 MoE,支持约 105 万 token 上下文与文本、图片、音频、视频输入,可用 MLX 在两台 M5 Ultra Mac Studio 上部署;报道称其 Terminal-Bench 2.1 与 DeepSWE 1.1 成绩低于 GLM 5.3 max 与 Kimi K3 max,许可为 Muse Model License。
发生了什么
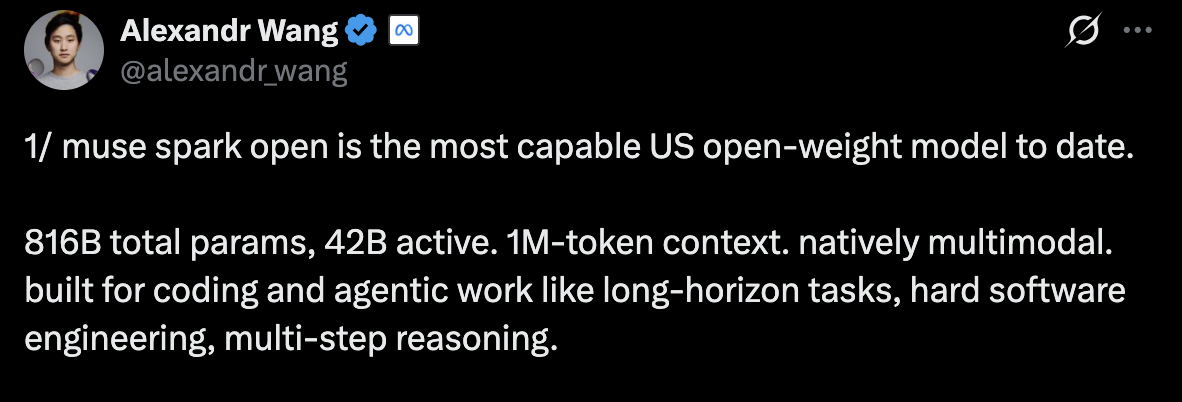
据 InfoQ 2026 年 10 月 18 日报道,Meta 于当地时间 10 月 15 日宣布开放 Muse Spark Open 模型权重,定位为面向软件工程、长程任务执行与多步推理的大型智能体模型,Meta 自称其为迄今能力最强的美国开放权重模型。该模型采用稀疏混合专家架构,总参数量 8160 亿,每个 token 激活约 420 亿参数,支持 1,048,576 token 上下文,可接收文本、图片、音频与视频输入,输出为文本。报道称 Meta 公布的评测结果为 JobBench 61.8、MCP-Atlas 89.2、OSWorld Verified 80.4,编程相关的 Terminal-Bench 2.1 为 76.4、DeepSWE 1.1 为 60,并指出后两项低于国产开源模型 GLM 5.3 max 与 Kimi K3 max。本地运行方案通过 MLX 在两台搭载 M5 Ultra 的 Mac Studio 上部署,苹果公布的四机分布式测试生成速度超过每秒 36 个 token;官方文档显示 BF16 权重约 1.65 TB、NVFP4 约 537 GB。授权采用 Muse Model License,要求展示指定归属标识,并对年收入合计超过 2000 万美元且以模型即服务方式提供模型的被许可方提出通知与单独书面协议要求,同时列出内部使用、研究等例外。
对开发者的影响
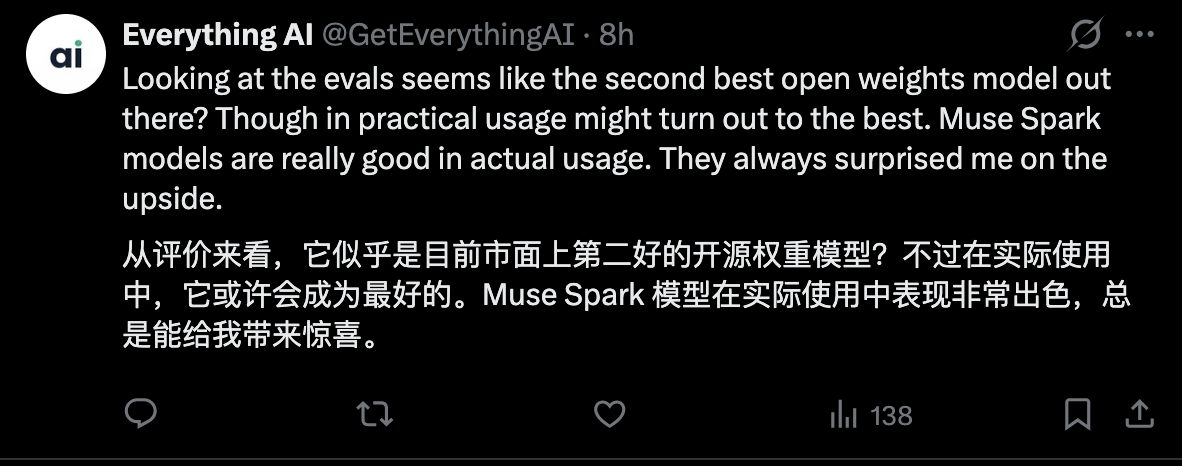
对开发者而言,这次发布的直接含义不是“多了一个可下载权重”,而是把大模型部署的决策变量从参数量拆成了三件事:权重存储、单 token 计算量和跨设备通信。报道中 8160 亿总参数与约 420 亿激活参数的区分很关键——前者决定装不装得下,后者决定算不算得动。按报道给出的口径,BF16 约 1.65 TB 需要 8 张 B300,NVFP4 约 537 GB 需要 4 张 B300,而苹果测试使用的是 NVFP4 而非 BF16;这意味着量化与多机并行是桌面部署成立的前提,任何一项都不能单独解释结果。同时,报道中两台各 512 GB 内存的 Mac 并不会合并为一台约 1 TB 统一寻址的机器,跨机需要 RDMA 与 MLX 集合通信,因此扩展收益会受通信限制。对已经在用 GLM 5.3 max 或 Kimi K3 max 做编码与长程任务的团队,这份对比提供了替换或互补的候选,但报道同时提醒 Terminal-Bench 2.1 与 DeepSWE 1.1 上 Muse Spark Open 并不领先,且官方演示(Ice Cubes iOS 开发、DaVinci Resolve 逐帧挑选)属于厂商展示,不能外推为同类任务均可无人值守。
接入与评估建议
以下为基于报道内容的建议与条件分析,不是已核实事实。第一,若你的工作负载是长程工具调用并需要数据不出本机,可先以托管 API 评估 Muse Spark Open 的任务完成率,再决定是否自建;报道列出的生态伙伴包括 Baseten、Fireworks AI、Groq、Modal、Nebius、Together AI 与 OpenRouter,部署工具覆盖 SGLang、vLLM、TensorRT-LLM、llama.cpp 与 MLX。选择是否自建的条件是你是否已有 NVFP4 可用的加速器或两台大内存 Mac,可评估指标是同一批真实工具调用任务在托管 API 与本地推理上的端到端成功率与单任务时延差。第二,在 NVFP4 与 BF16 之间做取舍时,报道给出的前提是 NVFP4 约 537 GB、BF16 约 1.65 TB,若你的显存或统一内存不足就必须走 NVFP4,代价是需要验证量化后长上下文的稳定性,可评估指标是接近 105 万 token 长度附近的信息召回准确率与工具调用成功率相比 BF16 的下降幅度。第三,若你为第三方提供模型即服务且年度合计收入可能超过报道所述的 2000 万美元门槛,应在把该模型或衍生模型投入业务前先确认通知与单独书面协议的适用性,并核对内部使用、研究与自有非模型即服务产品等例外是否覆盖你的场景;这是许可条款问题,需要法务判断而非工程判断。第四,若你计划用多机 Mac 扩展,不要按机器内存之和估算可用容量,报道指出跨机通信是独立瓶颈,可评估指标是两机与四机配置下每 token 生成速度的增量是否随机器数线性变化。
限制与待确认事项
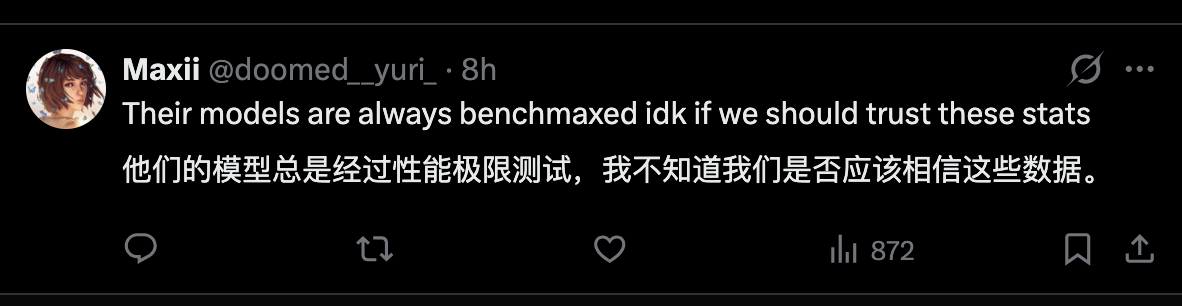
需要明确:Muse Spark Open 及其 816B-A42B 版本目前未出现在本站实时模型目录中,本站也没有该模型条目,因此前文提到的托管与 API 可用性均指厂商及其列出的第三方服务伙伴,不代表本站可调用。报道中所有评测分数、权重体积、硬件配置与许可条款均来自 Meta 官方口径与 InfoQ 转述,本文未独立复现,也未做实测;社区对榜单成绩可信度存在保留意见,报道中已有引述。开放权重不等于无商业条件,Muse Model License 的归属标识与收入门槛条款需按原文逐条确认,报道明确该条款存在内部使用、研究等例外,不应简化为“所有高收入企业都要付费”。报道中关于算子级 1.03—3.95 倍加速与 AMD MI350 上约 3% 端到端加速的说法属于算子级与端到端两个不同口径,不能外推为整体推理速度提升。官方演示与人物引用均为第三方陈述,不能视为无人值守能力的证据。此外,模型支持视频与音频输入仅表示理解能力,不具备原生生成能力;本地部署降低数据外传需求,但并不自动获得托管服务侧的安全检查与访问控制,智能体若获得过大文件与命令权限仍可能造成误改或数据损失。
原报道配图