英伟达发布 Nemotron 3.5 Bolt E4B:4GB 显存目标下的本地智能体,工具调用基准落后 Qwen3.5-4B
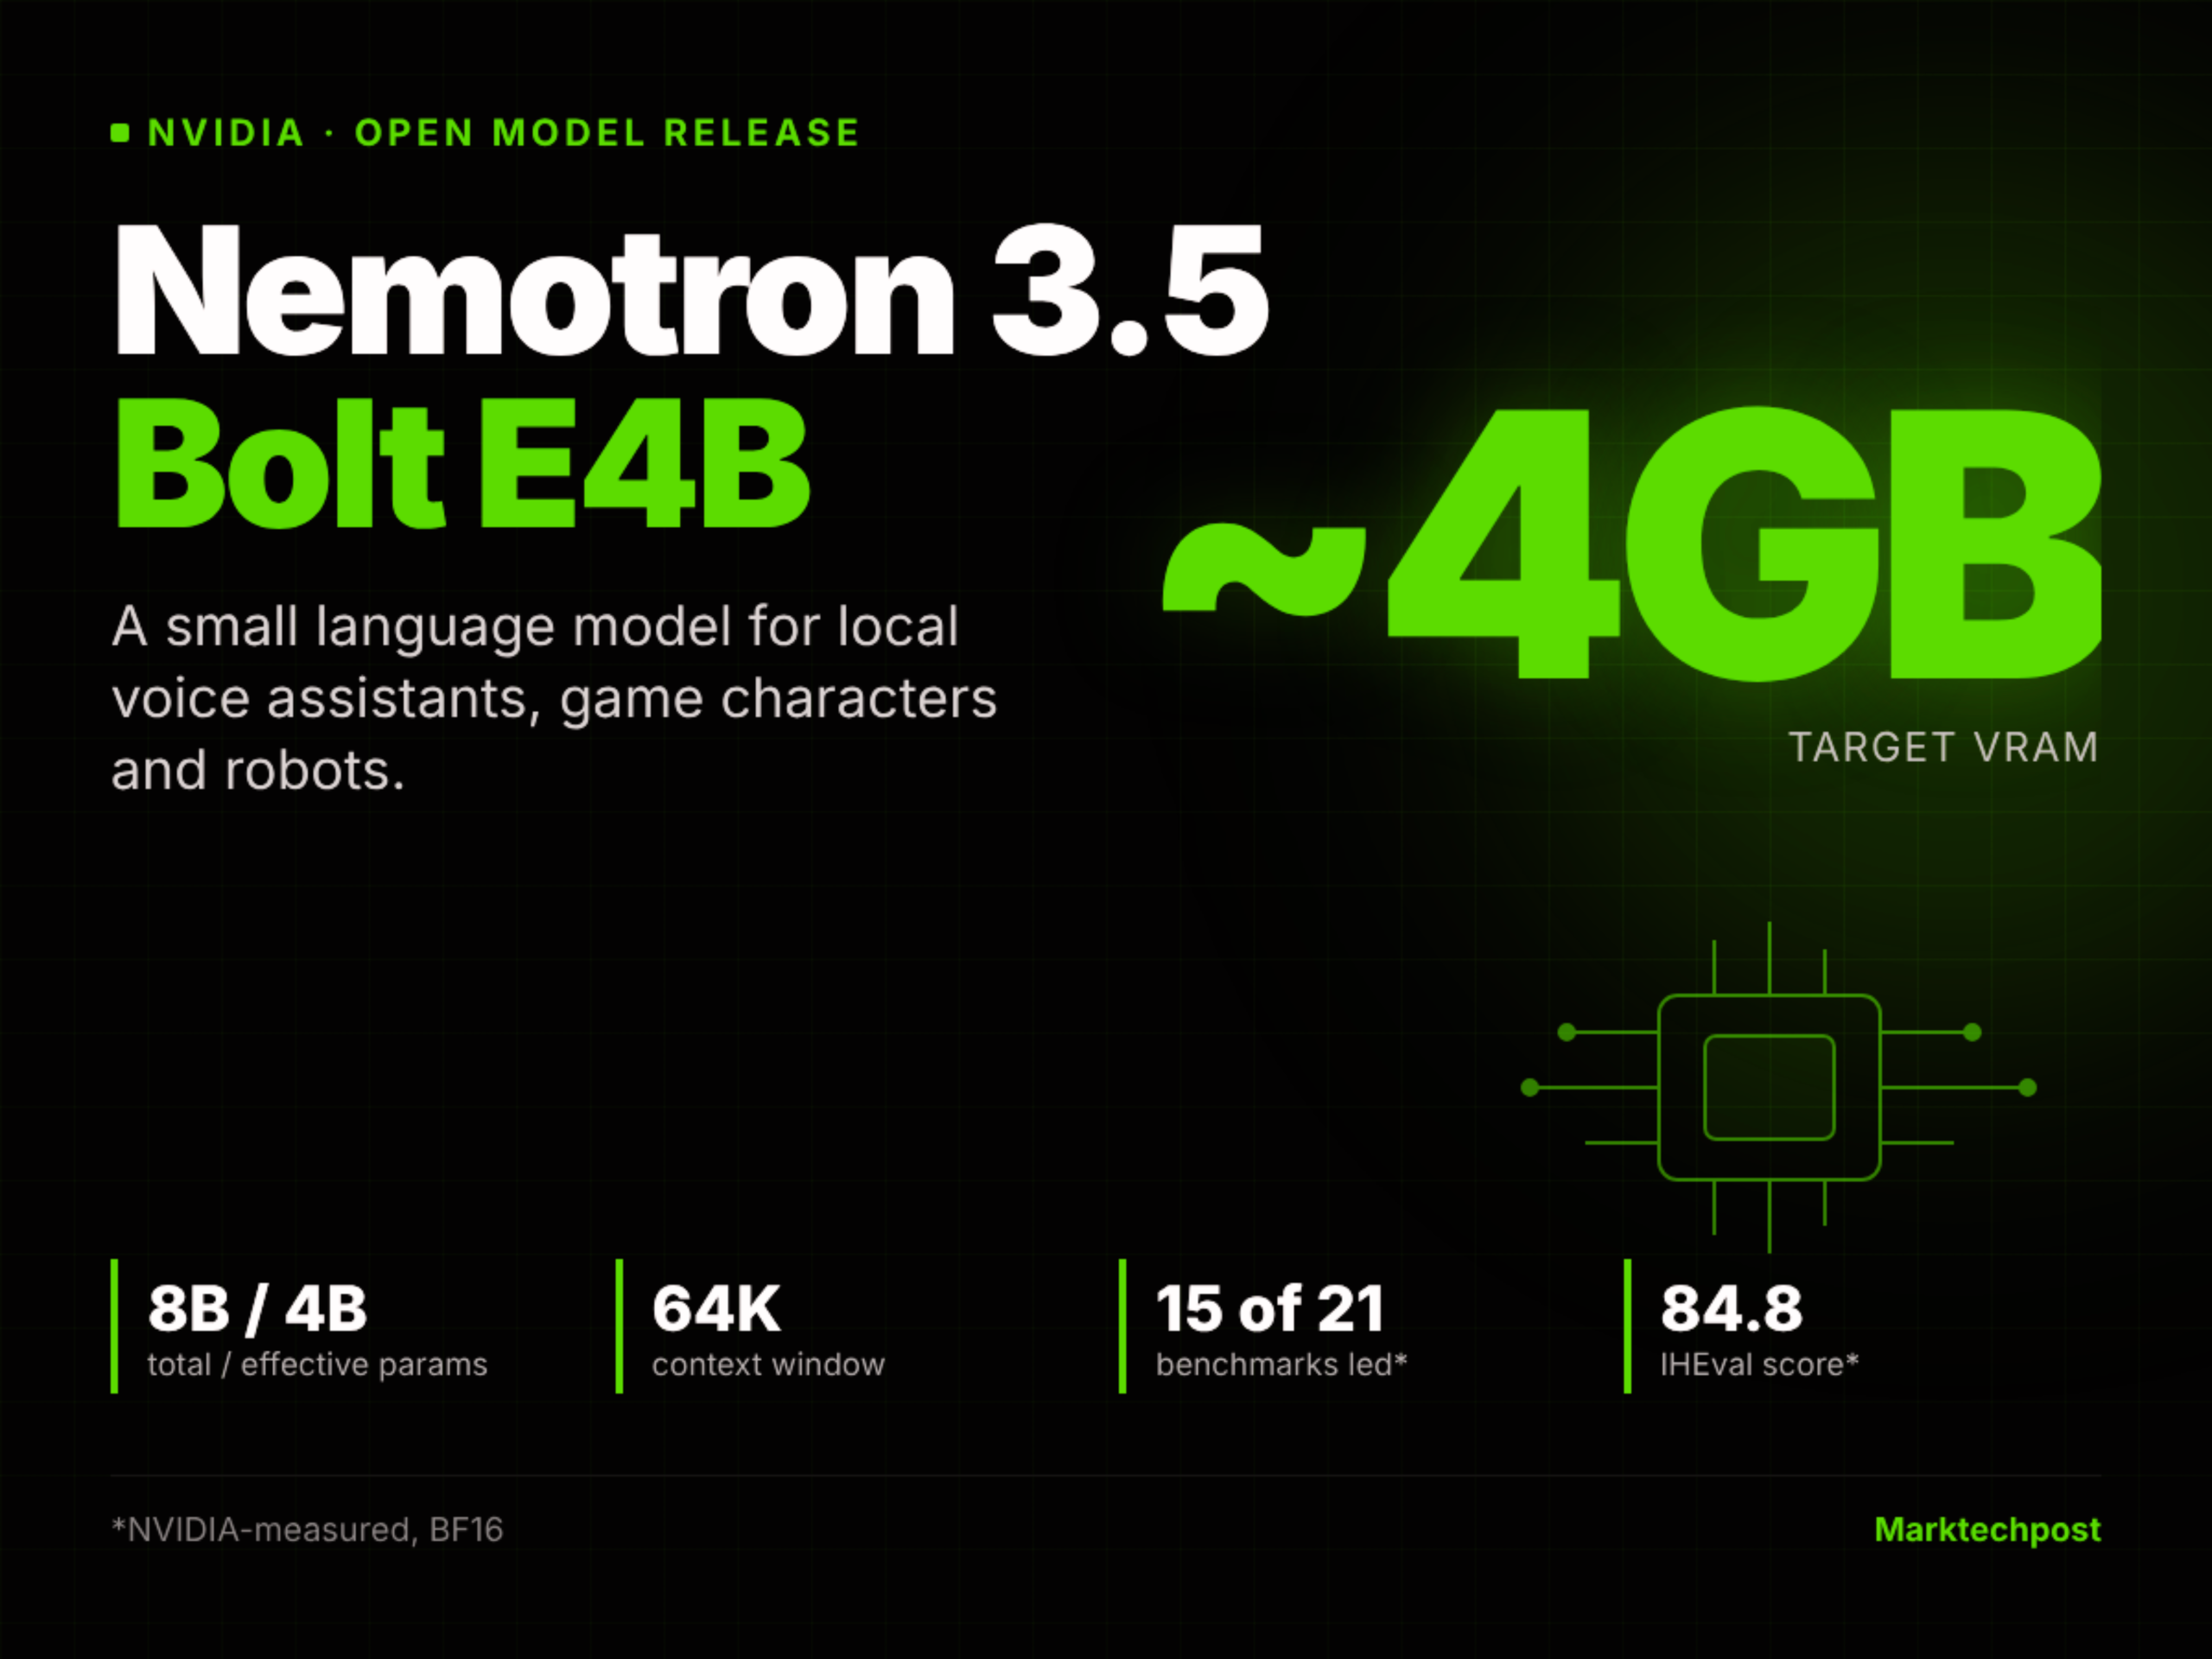
据 MarkTechPost 2026 年 10 月 23 日报道,英伟达发布开放权重模型 Nemotron 3.5 Bolt E4B,由 Gemma 4 E4B 仅经强化学习后训练,80 亿总参数、40 亿有效参数、64K 上下文,面向本地语音助手、游戏 NPC 与机器人。厂商自测 21 项基准 15 项领先,但 Tau2-Bench 55.1 落后 Qwen3.5-4B 的 75.1。
发生了什么
MarkTechPost 2026 年 10 月 23 日的报道称,英伟达发布 Nemotron 3.5 Bolt E4B,从 Google 的 Gemma 4 E4B 出发,完全跳过监督微调,只用 RLVR 与 RLHF 经 NeMo-RL、NeMo-Gym 后训练;每个训练样本同时跑推理与非推理两种模式,批次中非推理与推理样本保持 2:1,GenRM 环境的长度惩罚抑制答案变长,数据集与配方公开。模型 80 亿总参数、40 亿有效参数、64K 上下文,支持多轮工具调用和异步工具调用指引,带 conversational_mode 标志生成适合语音的短回复,推理能力与运行时思考预算可配置。报道称它是面向 NVIDIA ACE 游戏角色的第三代小模型,并展示了一台在 Jetson Orin Nano 8GB 上运行的 Reachy Mini 机器人,其中 Cosmos 3 Edge 负责视觉、Bolt 负责语音回复与工具调用。 部署侧,英伟达把 BF16 checkpoint 经重要性矩阵校准量化为 Q4_K_M,校准用约 100 万 token 的 RL rollout,并附带用于投机解码的 DFlash drafter:报道称 RTX 5070 上 Bolt 达到 272.6 tokens/s,Gemma 4 E4B 搭配其 MTP drafter 为 225.9 tokens/s。硬件实测(Q4_K_M、llama.cpp、batch size 1、3K 输入与 50 输出 token)显示 RTX 5070 占 3.5GB 显存、首 token 548 毫秒、133.4 tokens/s;Jetson AGX Orin 32GB 占 4.2GB、3687 毫秒、24.0 tokens/s;Jetson Orin Nano 8GB 占 4.2GB、5785 毫秒、15.5 tokens/s。报道强调“4GB”是目标显存区间而不是文件大小,Hugging Face 上的 Q4_K_M GGUF 为 6.18GB。 模型以 OpenMDW-1.1 许可发布权重,数据与配方公开,已上架 Hugging Face、Ollama、LM Studio、Unsloth 与 Jetson AI Lab,同时以 NVIDIA NIM 和 In-Game Inferencing SDK 形态提供,英伟达官方托管平台上另有免费 API。基准方面,报道中的分数均为 BF16、由英伟达在自家 NeMo-Gym 框架测得:21 项中 15 项最高,IHEval 84.8(Gemma 4 E4B 67.0、Qwen3.5-4B 60.6);Tau2-Bench 55.1,落后 Qwen3.5-4B 的 75.1,RULER 64K 为 87.0 也低于 Qwen3.5-4B 的 95.1,LongBench v2(50.5 对 59.9)与 BFCL-v3(68.5 对 70.9)同样由 Qwen3.5-4B 领先,Gemma 4 E4B 在 EQ-Bench v3 上以 41.1 对 39.4 略占优。报道还转述英伟达的说法:平均分比 Nemotron 3 Nano 4B 高约 40%,在开启推理的对比中输出 token 最多减少 80%。
对开发者的影响
对开发者的直接影响主要落在显存预算与任务分工两件事上。报道给出的显存数字都是裸模型推理口径,不含语音识别、语音合成或视觉模型;若参照报告里那台 Jetson Orin Nano 8GB 的演示来配置,模型本身已占 4.2GB,剩余余量决定了你还能放进多大的感知模型、能不能提高图像分辨率,以及是否必须换到 16GB 以上设备。首 token 时间的落差同样关键:RTX 5070 上 548 毫秒与 Orin Nano 上 5785 毫秒是完全不同的交互体验,后者更接近回合制而非自然插话式对话。 能力分布决定它更适合被当作专用件而非通用小模型。英伟达在 5 个能力域的 21 项基准里只声称领先 15 项,落败的几项集中在长上下文与智能体工具链:Tau2-Bench、RULER 64K、LongBench v2、BFCL-v3 都输给 Qwen3.5-4B。反过来,IHEval 84.8 这类指令跟随分数是它的强项,conversational_mode 也说明设计意图偏向短、快、可直接播报的回复。综合看,它是“对话加轻量工具调用”的候选,而不是复杂多轮规划或超长上下文检索的默认选择。 需要把口径差异算进判断。上述分数全部由厂商在自家测试框架测得,与第三方复现可能有差距;报道另提到 Scale Labs 在 MultiChallenge 上给出 56.03%,高于英伟达自报的 53.1。同一篇报道里两套数字并存,说明选型时不能把任一单个分数当作定论,尤其当你的业务分布与基准分布不一致时。
接入与评估建议
以下为基于报道的条件性建议与条件分析,不是已验证结论。 决策一:按目标设备的显存余量决定量化版本与部署形态。若设备是 8GB 级 Jetson 或 12GB 显卡,且需要同时跑语音与视觉模型,可优先验证 Q4_K_M 加 llama.cpp 这条路径——报道给出的 4.2GB 占用与 6.18GB 文件体积说明权重文件本身放不进“4GB”预算,量化运行形态才是可用形态。可测判据很具体:在你自己的输入长度下(报道用 3K 输入、50 输出 token)测首 token 延迟与 tokens/s,并确认叠加感知模型后仍有余量;如果首 token 超出交互设计能接受的上限,应先换更小或更激进的量化档,而不是继续调提示词。 决策二:按工作负载是否以工具调用为主,决定要不要让 Bolt 出场。若产品是语音助手式的短对话加少量工具调用,它的 conversational_mode 与 64K 上下文值得一测;若核心链路是多轮、带状态的长工具轨迹,报道中 Tau2-Bench 55.1 对 75.1 的差距提示应先以 Qwen3.5-4B 建立基线。可测判据是把你自己业务里的多轮工具调用轨迹整理成固定评估集,在同一套函数定义下比较任务完成率与平均调用轮数,而不是只看单轮回答是否流畅。 决策三:把运行时思考预算当成需要标定的参数,而不是开关。报道称模型支持可配置推理与运行时思考预算,并称开启推理的对比中输出 token 最多减少 80%(厂商说法)。这意味着同一份权重在开推理与关推理下是两条不同的延迟与质量曲线。做法是为语音链路设定一个延迟预算,在该预算内二选一,并以输出 token 数与首包时间作为可测指标,验证省 token 的说法在你自己的任务分布上是否成立。 决策四:许可需要单独核对。报道称权重以 OpenMDW-1.1 发布,而基座 Gemma 4 E4B 是 Apache 2.0,两者条款并不相同;把权重纳入产品前,应直接读许可正文确认分发、署名与商用条件,而不是从“开放权重”这类标签推断权限。
限制与待确认事项
本文所述 Nemotron 3.5 Bolt E4B 目前并未上架 KimiSeek,站内模型列表中没有对应条目;报道中提到的免费 API 指的是英伟达官方托管平台上该模型的可用性,与本站无关,实际可用性与条款须以厂商文档为准。 已知边界包括:报道中的全部基准分数为 BF16,由英伟达在自家 NeMo-Gym 框架中测得,不是独立复现;平均分高出 Nemotron 3 Nano 4B 约 40%、开启推理时输出 token 最多减少 80%,均为厂商自报。速度对比也有口径差异:272.6 对 225.9 tokens/s 是 RTX 5070 上 Bolt 配 DFlash drafter 与 Gemma 4 E4B 配 MTP drafter 的结果,与硬件表格中 133.4 tokens/s 的口径不同,两者不能直接互换使用。MultiChallenge 上英伟达自报 53.1,报道转述的一则 X 帖称 Scale Labs 给出 56.03%,两个数字需要分别标注来源。许可方面,Bolt 以 OpenMDW-1.1 发布、基座 Gemma 4 E4B 为 Apache 2.0,开放权重不等于等同的商用条款。硬件数据只覆盖 RTX 与 Jetson 四档设备,其他平台没有数据。输入形态上,按报道的对比表,Bolt 模型卡标注的输入为文本,NIM 形态还接受图像与音频;实际可用的模态与限制仍需以官方文档为准,报道未给出这些模态的评测数据。