Reflection Beam 开放权重 501B 模型发布:Apache 2.0 权重与 AWS 两条部署路径
据 AWS 于 2026 年 10 月 16 日发布的博客,Reflection AI 推出开放权重模型 Beam,面向智能体编码与长周期任务,501B 总参数、23B 激活参数,报告有效上下文 100 万 token,权重以 Apache 2.0 经 Hugging Face 发布,提供 BF16/FP8/NVFP4 检查点,并给出 SageMaker JumpStart 与 HyperPod 两条部署路径。
发生了什么
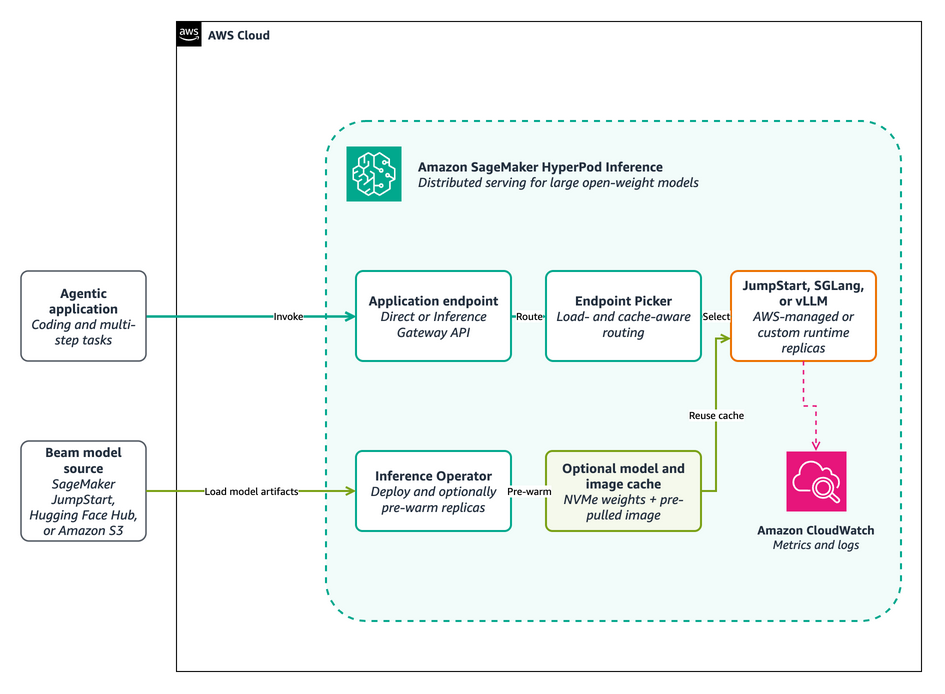
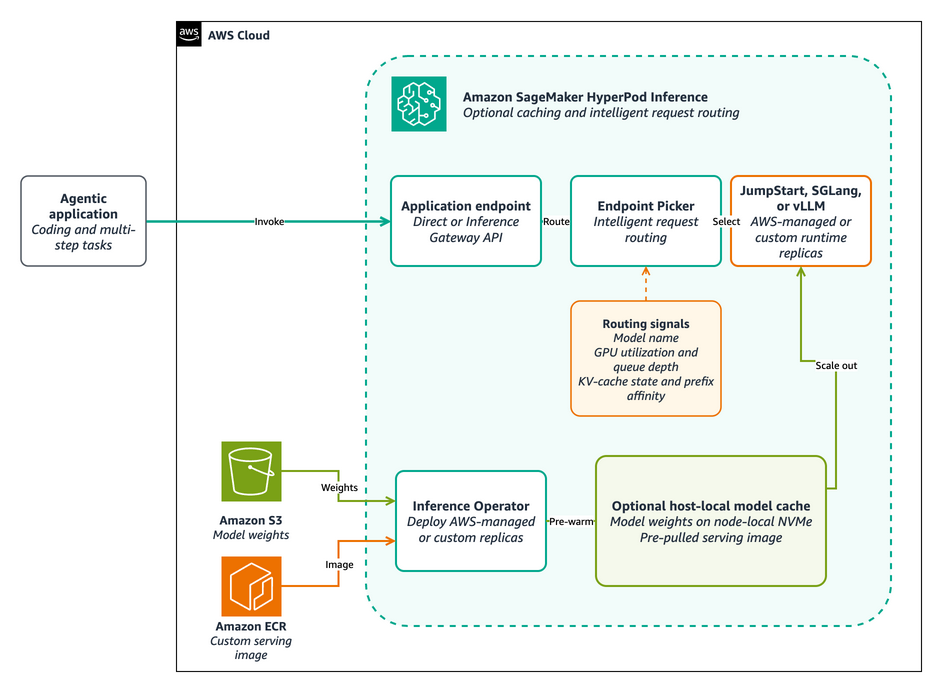
据 AWS 官方博客 2026 年 10 月 16 日报道,Reflection AI 发布开放权重模型 Beam,定位智能体编码与长期任务,例如维护代码、调用工具、解释结果并完成多步工作流。该模型为稀疏专家混合(MoE)结构,5010 亿总参数、230 亿激活参数,Reflection 报告有效上下文长度为 100 万 token。Reflection 通过 Hugging Face 以 Apache 2.0 许可证发布 Beam 权重,Beam 1.0 提供 BF16、FP8、NVFP4 三种检查点变体,用于适配不同内存占用与硬件。发布时该模型在 Amazon SageMaker JumpStart 中于美国东部(弗吉尼亚北部)与俄亥俄两个区域提供。博客同时给出两条部署路径:SageMaker JumpStart 实时端点(全托管)与 SageMaker HyperPod Inference(配合 JumpStart 托管容器或自定义 SGLang、vLLM)。文中还给出按精度选择实例的指引:FP8 使用 H100 的 ml.p5.48xlarge 或 H200 的 ml.p5e/ml.p5en.48xlarge,NVFP4 使用 B200 的 ml.p6-b200.48xlarge,并强调 BF16 权重内存需求最大、需要多节点规划。需要并列的是,这是该博客的报道性描述,KimiSeek 未对模型能力、实例支持或区域可用性做独立验证。
对开发者的影响
对开发者的直接后果是:这是一次开放权重发布,且声明为 Apache 2.0 许可,这在许可层面比仅“权重可下载”更明确,但许可权利仍应以 Hugging Face 仓库与条款文本为准,不能由“权重可得”反推商用、再分发或衍生训练的授权范围。工程上,501B/A23B 的稀疏结构意味着显存与部署成本由总参数决定、单 token 计算更接近 23B 激活规模,因此权重内存、分片与并行布局是首要约束:BF16 需要多节点聚合显存,FP8 与 NVFP4 则把可行硬件收窄到 H100/H200 与 B200 特定实例。部署形态存在真实取舍——JumpStart 实时端点把模型、容器与端点封装为托管工作流,适合快速验证;HyperPod 暴露集群与运行时,允许固定镜像摘要、Beam commit SHA 与并行参数,适合需要复现性能结果或自定义量化、解析器的团队。博客提到的 100 万 token 有效上下文会影响 KV 缓存预算与批处理策略,长上下文下的显存占用需要实测而非估算。对评测而言,该模型面向多步工具调用,单轮问答基准不足以说明其在真实智能体回路中的表现,需要以代表性编码与工具使用请求构造负载。
接入与评估建议
以下为基于该博客的评估建议,不是已核实结论。第一,先决定“托管还是自管”:若目标是尽快跑通集成、团队没有 Kubernetes 运维能力,用 JumpStart 实时端点跑一条有界生命周期(部署、单次请求、清理),把成功条件设为端点就绪后能返回符合已发布请求 schema 的响应;只有在需要固定运行时参数、量化或自定义解析器时,才转向 HyperPod 上的 SGLang 或 vLLM,此时以镜像摘要、模型修订与并行配置可复现为通过条件。第二,按精度做一次容量决策:以单副本权重、KV 缓存与运行时开销估算聚合显存,再用负载测试校正;若目标上下文接近报告的有效上限,先验证长上下文下的 p95 首 token 时间与每输出 token 时间是否满足延迟预算,若使用 NVFP4 或 FP8,必须重新检查输出质量是否出现退化。第三,为智能体场景设一条可度量验收线:以真实代码修复与多步工具调用请求、按预期并发重复施压,记录成功率、p50/p95 首 token 时间、端到端延迟与聚合输出吞吐,并把模型版本、镜像摘要、精度、上下文长度与缓存状态一并留档,否则跨配置对比不可比。第四,先小规模验证再扩容:确认所选实例类型的服务配额与区域容量,注意镜像传输、权重下载与分片加载会占用可观的冷启动时间,缓存与自动扩缩策略应基于实测而非预设。第五,测试完成后按官方示例清理端点、集群、缓存权重与临时 IAM 资源,避免持续计费。
限制与待确认事项
本次发布对应的 Beam 1.0(501B/A23B)目前并未在 KimiSeek 上架,因此本文所述部署路径、调用方式与任何可用性均指 Reflection AI 与 AWS 的发布渠道,而非本站服务;KimiSeek 上的 Kimi K3、GLM、Qwen、DeepSeek 等为不同模型,不构成该版本的可用性证据。本报道基于 AWS 博客的单一来源,KimiSeek 未独立验证参数量、有效上下文长度、Apache 2.0 许可的实际适用范围、各检查点变体的硬件兼容性、两个美国东部区域的可用状态,以及模型的基准表现;博客未提供公开的编码或智能体基准分数,能力声明不应视为已核实事实。开放权重不等于完整开源:许可条款、训练数据与复现材料仍需以 Hugging Face 仓库与 Reflection 官方声明为准。文中提到的 HyperPod 缓存、路由与网关能力属于 2026 年 SageMaker 的功能范畴,其行为随版本变化,应查阅对应文档;实例类型与区域也可能随时间调整。关于成本,请以 Reflection AI、Hugging Face 与 AWS 各自的定价或计费页面为准,价格与配额会变动。此外,博客中的采样参数(如 temperature 与 top-p)仅为示例起始值,不代表推荐配置。
原报道配图