Reflection Beam 与 Mistral Large 4 同期亮相:开放权重选项增加,但权重与许可尚未落地
据 InfoQ 中文站 2026 年 10 月报道,10 月 5 日至 6 日美国 Reflection 发布首款开放权重 MoE 模型 Beam,法国 Mistral 推出迄今最大的 Mistral Large 4。报道称 Beam 推理效率为卖点、部分基准接近 GLM-5.2 但落后中国最新一代;Large 4 已开放 API 预览、完整权重计划 10 月底发布,两款版本目前均未在 KimiSeek 上架。
发生了什么
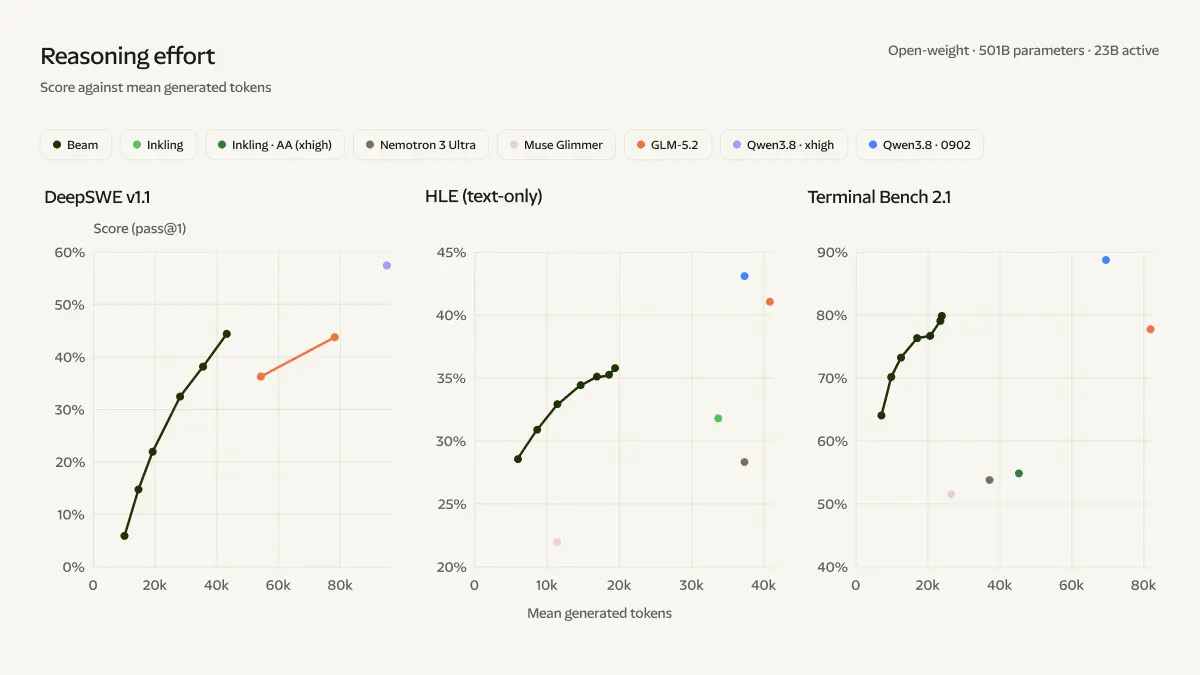
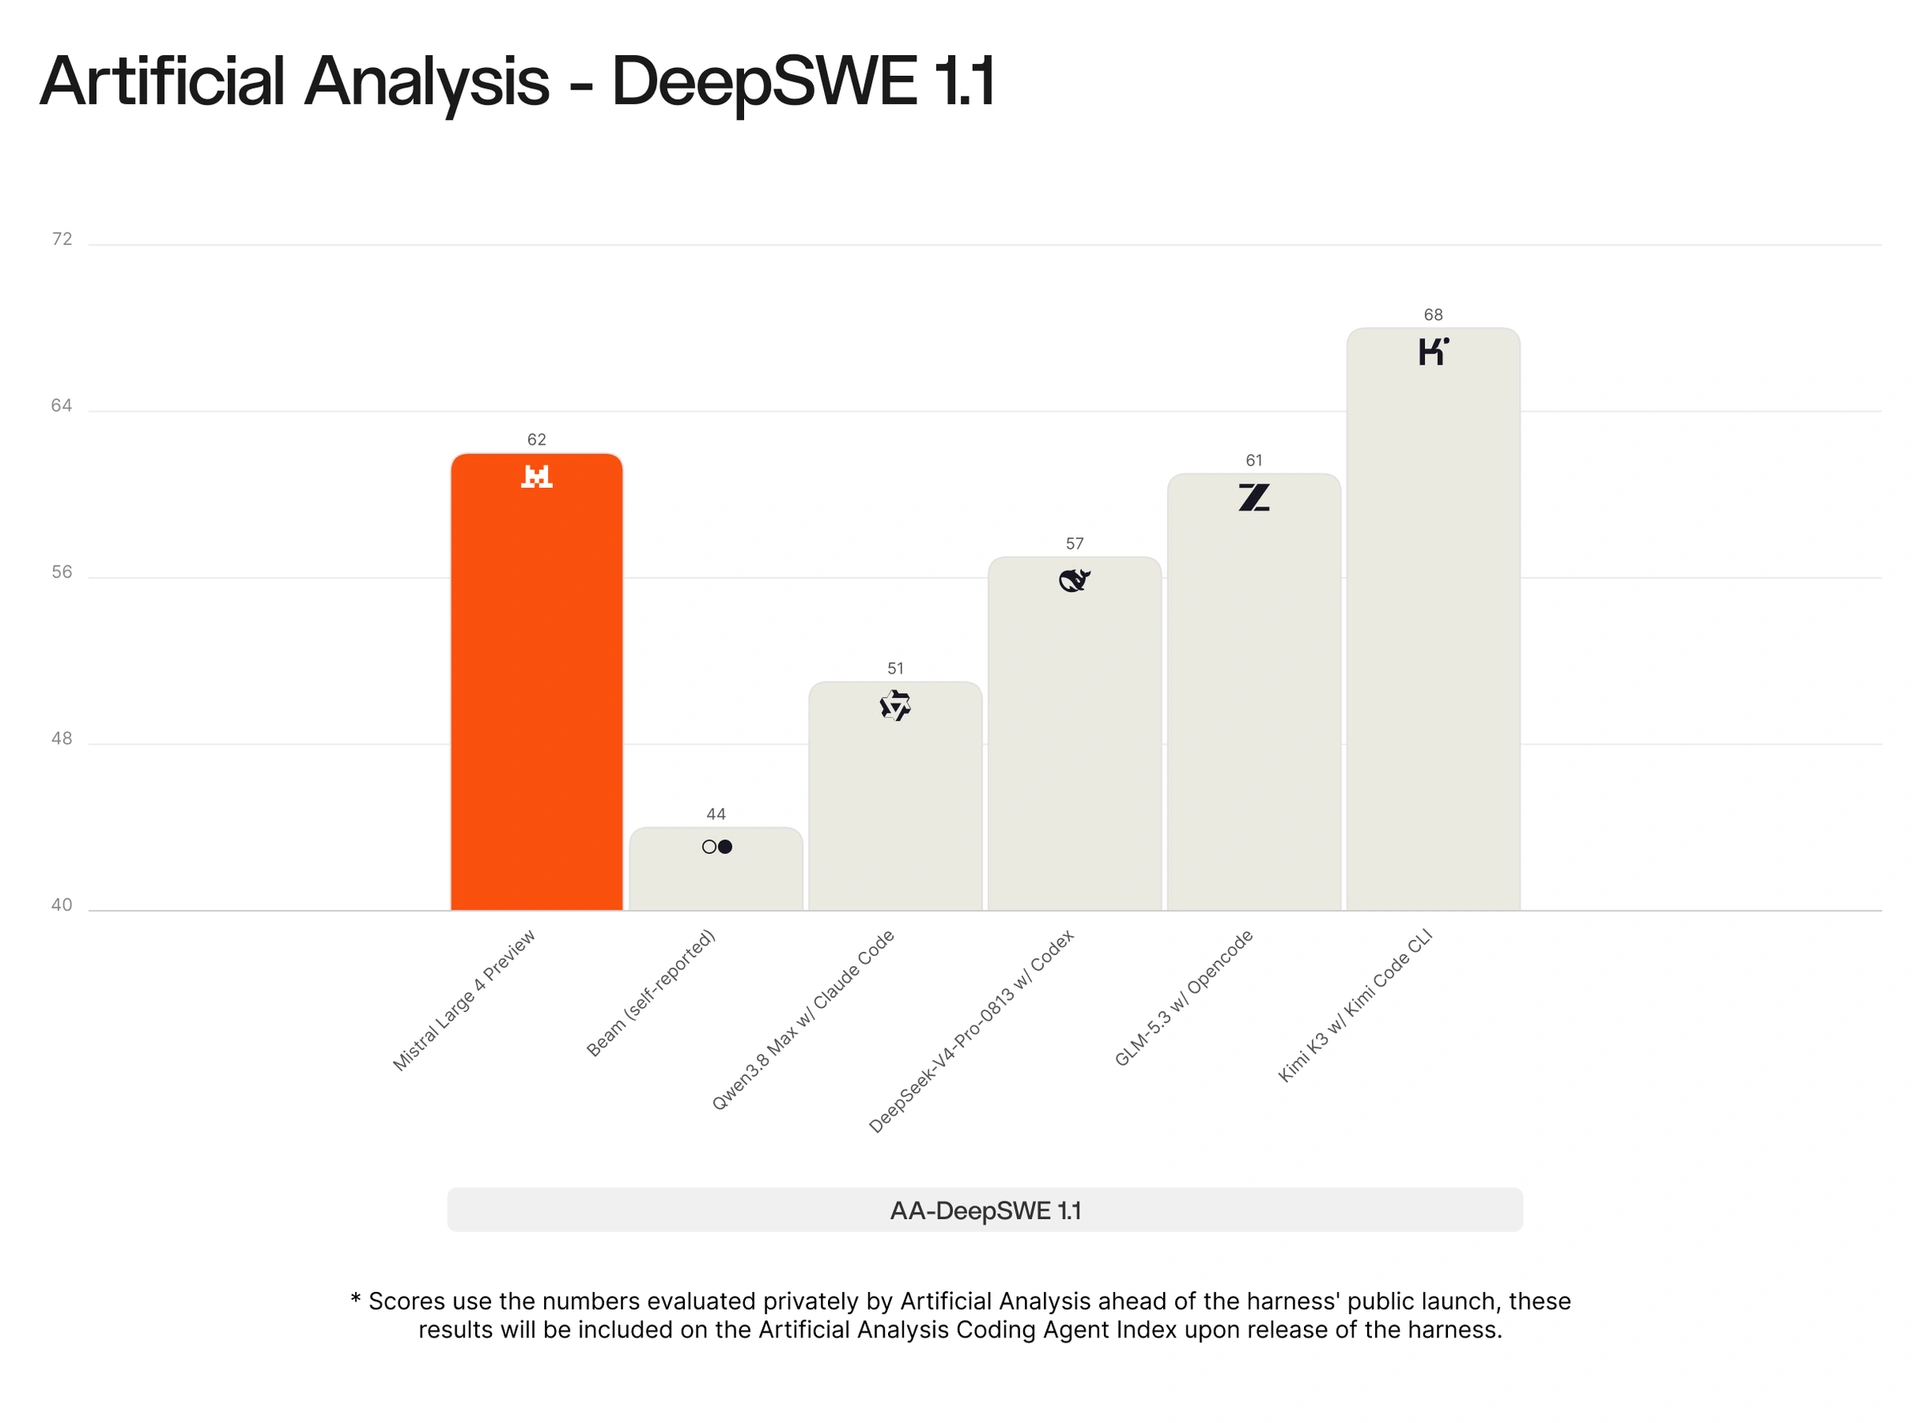
据 InfoQ 中文站报道(原文标注为当地时间 10 月 5 日至 6 日),美国创业公司 Reflection 发布首款开放权重模型 Beam,一天后法国 Mistral 推出 Mistral Large 4。报道称 Beam 为 MoE 模型,总参数 5010 亿、每 Token 激活 230 亿,面向编程、推理与 Agent 工作负载,使用 23.8 万亿 Token 预训练,并动用 1.05 万张 Nvidia GB300 连续四周高算力强化学习、生成逾 1 亿次 rollout;发布时仍处最终红队测试阶段,报道称 Reflection 计划在 10 月公开权重、技术报告与开发工具。Mistral Large 4 据报道为激活 520 亿、总参数 1.05 万亿,含 16 亿参数视觉编码器,原生多模态,支持超过 160 种语言,上下文窗口 100 万 Token,据称在欧洲数据中心以约 3800 张 Nvidia Grace Blackwell GPU 从头训练,报道时已开放 API 预览,完整权重计划 10 月底发布。报道转述的基准数据中,Beam 在 DeepSWE v1.1 得 44.4、Terminal Bench v2.1 得 80.1,均低于报道所列 GLM-5.3、Kimi K3 与 DeepSeek V4.1 Flash 的成绩;在 Humanity's Last Exam 上 Beam 得 36.2,低于原文同时列出的 GLM-5.3 的 42.3 与 Kimi K3 的 46.9(原文未给出 DeepSeek V4.1 Flash 的该项分数)。Mistral 一侧,报道称 Large 4 在官方 Coding Agent Index 超过 DeepSeek V4 Pro 与 Qwen 3.8 Max、低于 Kimi K3,在 AutomationBench 超过 Kimi K3、MiMo-V2.6-Pro 与 DeepSeek V4 Pro、低于 GLM-5.3。上述分数分别来自厂商自述或厂商引用的第三方测试,属报道转述,未经独立复现。
对开发者的影响
这组发布改变的是开放权重阵营的候选集合与比较坐标,而非立即改变中国模型的可得性。最具工程含义的一点是 Reflection 把 Beam 的卖点从绝对能力转向“单位推理算力换取多少智能”,报道称部分高级推理任务可用 GLM-5.2 约四分之一到三分之一的算力达到接近表现;若该说法在自有负载上成立,影响的是长链 Agent 与批量推理的每任务成本结构。但按报道转述的基准,Beam 追平的主要是中国上一代模型,在 DeepSWE v1.1 与 Terminal Bench v2.1 上低于原文同时列出的 GLM-5.3、Kimi K3 与 DeepSeek V4.1 Flash,在 HLE 上低于原文列出的 GLM-5.3 与 Kimi K3,因此“用更少算力换接近能力”与“用同等算力换更高质量”是两条不同的替换路径,不能互相替代。Mistral Large 4 的侧重不同:百万级上下文、原生多模态与多语言,加上报道强调的私有云或本地部署与自定义安全策略,指向跨应用企业工作流与需自控数据边界的场景,而非纯编程基准比拼。须区分概念:两家都被描述为开放权重,但报道中权重可得时点不同,发布时二者均未真正开放权重;开放权重指可下载的模型文件,与训练数据、训练代码及许可条款是否开放是不同问题,报道未提供许可细节,不能据此推断商用、再分发或微调权利。另据当前目录核对,Beam 与 Mistral Large 4 在 KimiSeek 均无对应条目,报道所述 API 预览与可用性指厂商自身渠道。
接入与评估建议
以下为条件性分析或建议,不是报道事实。第一,若主要负载是长链 Agent 编程且成本敏感:报道称 Beam 能以约为 GLM-5.2 四分之一到三分之一的推理算力接近其表现,而当前可用同类选项包含 GLM-5.2 与 DeepSeek V4.1 Flash,可先用自有多轮工具调用轨迹做小样本对比,测量指标为“每完成一个任务的总 Token 与端到端延迟”,前提是能接受其在报道基准中低于中国最新一代的水平;若失败率升高触发重试,算力节省会被抵消,此时不宜替换,可把评估标准设为同一任务集端到端成功率下降不超过预设阈值。第二,若负载需要百万级上下文、多模态输入或多语言:Mistral Large 4 据报道支持 100 万 Token 上下文与 160 种以上语言,但权重与最终条款未定,应先在 API 预览阶段验证长上下文检索准确率与视觉编码器在自有文档上的表现,衡量指标为长上下文问答准确率与单位请求成本,前提是不把预览版行为等同于未来开放权重的行为,并保留现有主力模型作为回退。两条规则都应在权重正式发布并明确许可后再复核一次。
限制与待确认事项
报道内容主要来自厂商自述与厂商引用的第三方测试,基准分数未经独立复现,不应视为已验证结论。尤其需要指出:原文在 Humanity's Last Exam 上只给出 Beam 36.2、GLM-5.3 42.3 与 Kimi K3 46.9,并未列出 DeepSeek V4.1 Flash 的 HLE 分数,因此 HLE 的比较对象应限定为原文实际列出的 GLM-5.3 与 Kimi K3;把三个基准合并为“均低于三家”属原文未支持的跨基准比较。此外,Beam 与 Mistral Large 4 在 KimiSeek 当前模型中均无对应条目,即这两个版本目前未在 KimiSeek 上架,报道所述 API 预览与权重发布计划指厂商自身渠道的可用性,与 KimiSeek 是否提供无关。权重可得性不等同于开放源代码许可,报道未给出许可条款,商用与再分发权利需以厂商实际发布的许可为准。报道称 Beam 权重计划 10 月公开、Large 4 完整权重计划 10 月底发布,发布时二者均未真正开放权重,后续是否按期兑现、条款如何变化仍属未知。“约四分之一到三分之一算力”的说法为 Reflection 自述,缺少独立测量口径,实际替换效果需在自有负载上验证。本简报不对两家公司未来路线图或商业模式承诺的兑现作判断。
原报道配图