Supersonic Labs 发布 Julia 1:1.443 亿参数 Apache 2.0 决策模型,可在 CPU 端侧运行
据 MarkTechPost 2026 年 9 月 26 日报道,巴西 Supersonic Labs 发布 Julia 1,基于 mmBERT-small 的 1.443 亿参数决策模型,权重以 Apache 2.0 释出,支持 choice、score、noul 三类调用,可在 CPU 本地运行。其试验在 Typed Decisions、AG News、DAIR Emotion 上超过 Jev 参考值,但在 72 标签 Banking77 上明显落后,托管 API 已宣布但尚未开放。

发生了什么
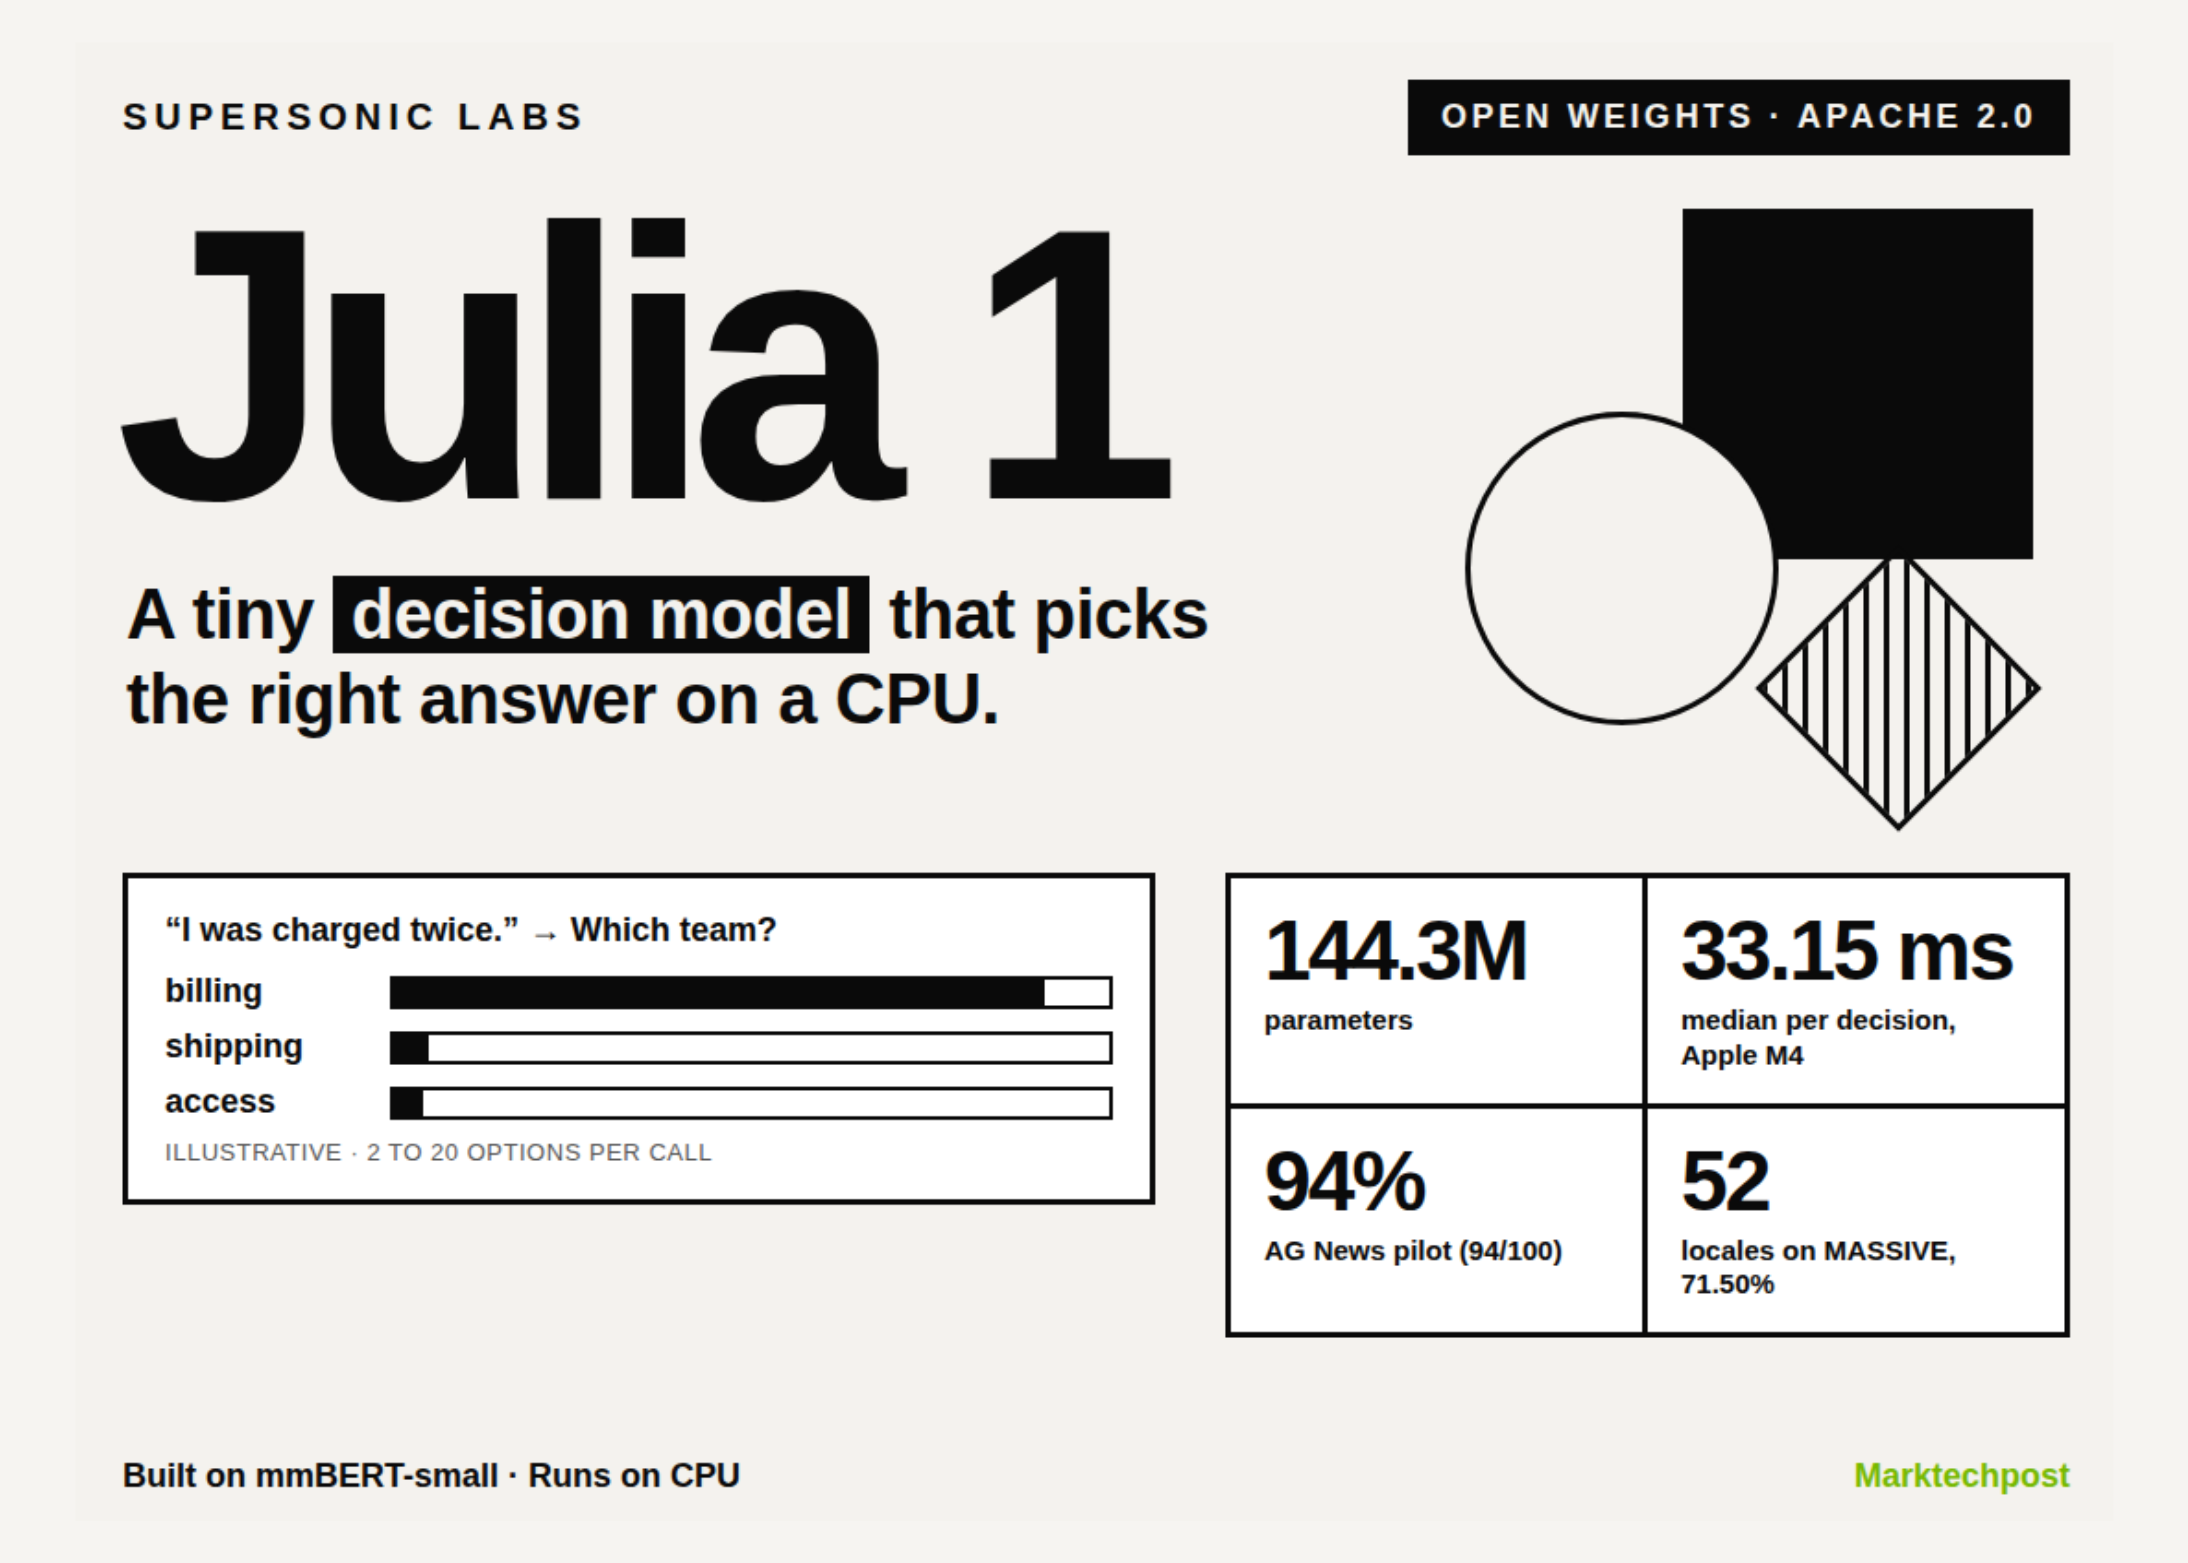
据 MarkTechPost 2026 年 9 月 26 日报道,巴西小型实验室 Supersonic Labs 发布 Julia 1(注意:该版本目前未在 KimiSeek 目录中列出,报道中的 API 可用性指厂商侧)。它是一个决策模型而非聊天模型:调用方传入上下文、问题与 2 到 20 个带描述的候选答案,模型按给定顺序返回选中项及完整 softmax 概率,调用方 ID 会原样回传,不生成自由文本。权重以 Apache 2.0 发布在 Hugging Face 上(权重可获取不等于具备开源许可证,此处来源明确为 Apache 2.0),Python 3.11+ 环境下可在 CPU 或支持 BF16 的 GPU 运行,另有 ONNX 构建可经 WebGPU 在浏览器运行;托管 API 已宣布但尚未开放。模型基于 JHU CLSP 的 mmBERT-small 编码器加决策头,实验室明确表示并非微调 Qwen。运行时合并 token 上限 8,192,公开基准使用 1,024。三类调用为 choice(分类、路由)、score(有序评分返回期望索引)、noul(是/否为真的概率)。报道中 2026 年 9 月 24 日的评测在 H200 BF16 上以严格编码方式运行,对比对象是 TypeSafe Jev 基准协议中的参考值而非重跑 Jev:Typed Decisions 73.15%(参考 72.70%)、AG News 94/100(参考 91%)、DAIR Emotion 86/100(参考 48%)、Banking77 仅 64/100(参考 87%)、MASSIVE 跨 52 个语言区域宏平均 71.50%,pt-PT 86.25%、en-US 86.75%。分类试验每项仅 100 个样本。9 月 25 日一次 CPU 运行复现出 Typed Decisions 72.55%、Banking77 60/100 并有 3 次弃答。延迟方面,报道称 Apple M4 单次决策中位 33.15 毫秒,三星 SM-X510 平板经 ONNX Runtime 中位 203 毫秒、峰值 RSS 393.1 MB,Intel Core i5-1235U 上 AG News 中位 107.83 毫秒,而 Banking77 因需先收窄 72 个标签需 3,713.54 毫秒。
对开发者的影响
对开发者的直接影响是出现了一种把"分类/路由/评分"从大模型里拆出来、放到端侧小模型上的可选路径。1.443 亿参数、FP32 权重约 550.5 MiB,意味着它可以塞进手机、平板、笔记本甚至浏览器,不必为每次分类调用付费或联网;报道中计划中的 API 报价是 $0.025/百万输入 token,但该 API 尚未开放,且该报价的报道日期是 2026 年 9 月,读者应以厂商最新页面而非本文为准确认当前价格。同时必须看清其能力边界:它只在你给出的候选项之间做比较,不能补全缺失事实、做代数或多步计算,Router 在收窄过程中可能丢弃正确标签,也不是可直接替换现有 Transformers pipeline 的组件,报道称没有 Hugging Face 推理提供方托管它。基准层面最重要的信号不是"三项超过 Jev",而是标签空间从 4、6 扩到 72 时的急剧退化:AG News 94/100 对 Banking77 64/100,且 CPU 复现只有 60/100,说明它更适合粗粒度、少标签的判定,而非细粒度多分类。另外,报道中"比 Jev 快 5 倍"的说法来自厂商 X 帖文,而 Jev 试验是把 Jev 当托管服务从法国发起调用测得,延迟并非同等条件对比,不宜直接采信。
接入与评估建议
以下为基于报道的条件性分析与建议,不是已核实的事实。第一项决策:是否把该模型的输出直接用作线上自动路由。报道中"标签数越多越差"(Banking77 64/100、CPU 60/100)与"Router 可能丢标签"是两个不同的变化,需分开处置;若你的场景标签数超过约二十个、且误判会触发扣款、权限或退款等不可逆动作,建议不要直接执行模型输出,而应接入第二道判定或人工复核;若标签数很少(例如 4 类以内的粗分类)且动作可回滚,可先进入灰度。可测量的评估标准:在你自己采样的至少 200 条真实请求上,对比模型选中项与人工标注的一致率,并单独统计"正确答案被 Router 收窄阶段排除"的比例。第二项决策:是否用端侧部署替代现有托管分类调用。报道给出的设备实测是 M4 中位 33.15 毫秒、SM-X510 中位 203 毫秒、i5-1235U 上 AG News 中位 107.83 毫秒,而 Banking77 高达 3,713.54 毫秒,这意味着候选数量或标签规模是决定可行性的前提条件;当你的请求以少标签短文本为主且可接受百毫秒级、无网络的本地推理时,端侧更划算;当标签规模大或需要低延迟高并发时,端侧 CPU 路径可能不成立。可测量的评估标准:在你的目标设备上固定输入长度,分别压测每类决策的 P50 与 P95 延迟及峰值内存(报道参考值 RSS 393.1 MB),并与现有方案同机对比。第三项决策:是否现在就把业务迁到托管 API。报道明确说该 API 已宣布但尚未开放,因此现阶段只能自托管;建议先用本地权重做小规模验证,把 API 侧的可用性、限流与计费确认清楚后再决定是否切换,不要基于报道中的计划报价做容量规划。评估步骤上,建议先固定 1,024 token 以内的输入并按报告口径构造候选,做离线一致率测试,再进行设备压测,两项都达标再上灰度。
限制与待确认事项
本次报道的核心局限是样本与对比口径。分类试验每项仅 100 个样本,Typed Decisions 虽为 2,000 条但其余项置信区间较宽,不足以支撑强结论;对比基线使用 Jev 协议中的参考值而非在同一环境重跑 Jev,且 Jev 延迟是托管服务跨境调用测得,与该模型的本地运行不具可比性,厂商"快 5 倍"的说法因此需要独立验证。模型的私有训练流水线未公开,无法核查数据构成与潜在偏置。9 月 25 日 CPU 复现出现 3 次弃答,说明低配环境下行为可能退化。报道声称的托管 API 在本文写作时尚未开放,计划中的 $0.025/百万输入 token 报价来自 2026 年 9 月的报道,价格会变,请以厂商定价页面为准。需要特别说明:Julia 1 这一版本目前未在 KimiSeek 目录中列出,报道中提到的 API 可用性指的是厂商侧的安排,与 KimiSeek 平台无关。此外,报道未给出候选答案措辞、顺序敏感性、多语言稳定性(MASSIVE 仅报宏平均与两个语言区域)等细节,这些都可能影响实际表现,需要读者自行测试确认。
原报道配图