Underdog 发布 Saluki 27B:7.89GB 的 2-bit Qwen3.8-27B,工具调用反超原版
据 MarkTechPost 2026 年 10 月 9 日报道,Conway Research 旗下 Underdog 以 Apache 2.0 发布 Saluki 27B,将 54GB 的 Qwen3.8-27B 压到 7.89GB 的 2-bit 混合 GGUF,可在原版 llama.cpp 运行;其工具调用得分反超原版,但竞赛数学与多步推理低 12 至 18 分。
发生了什么
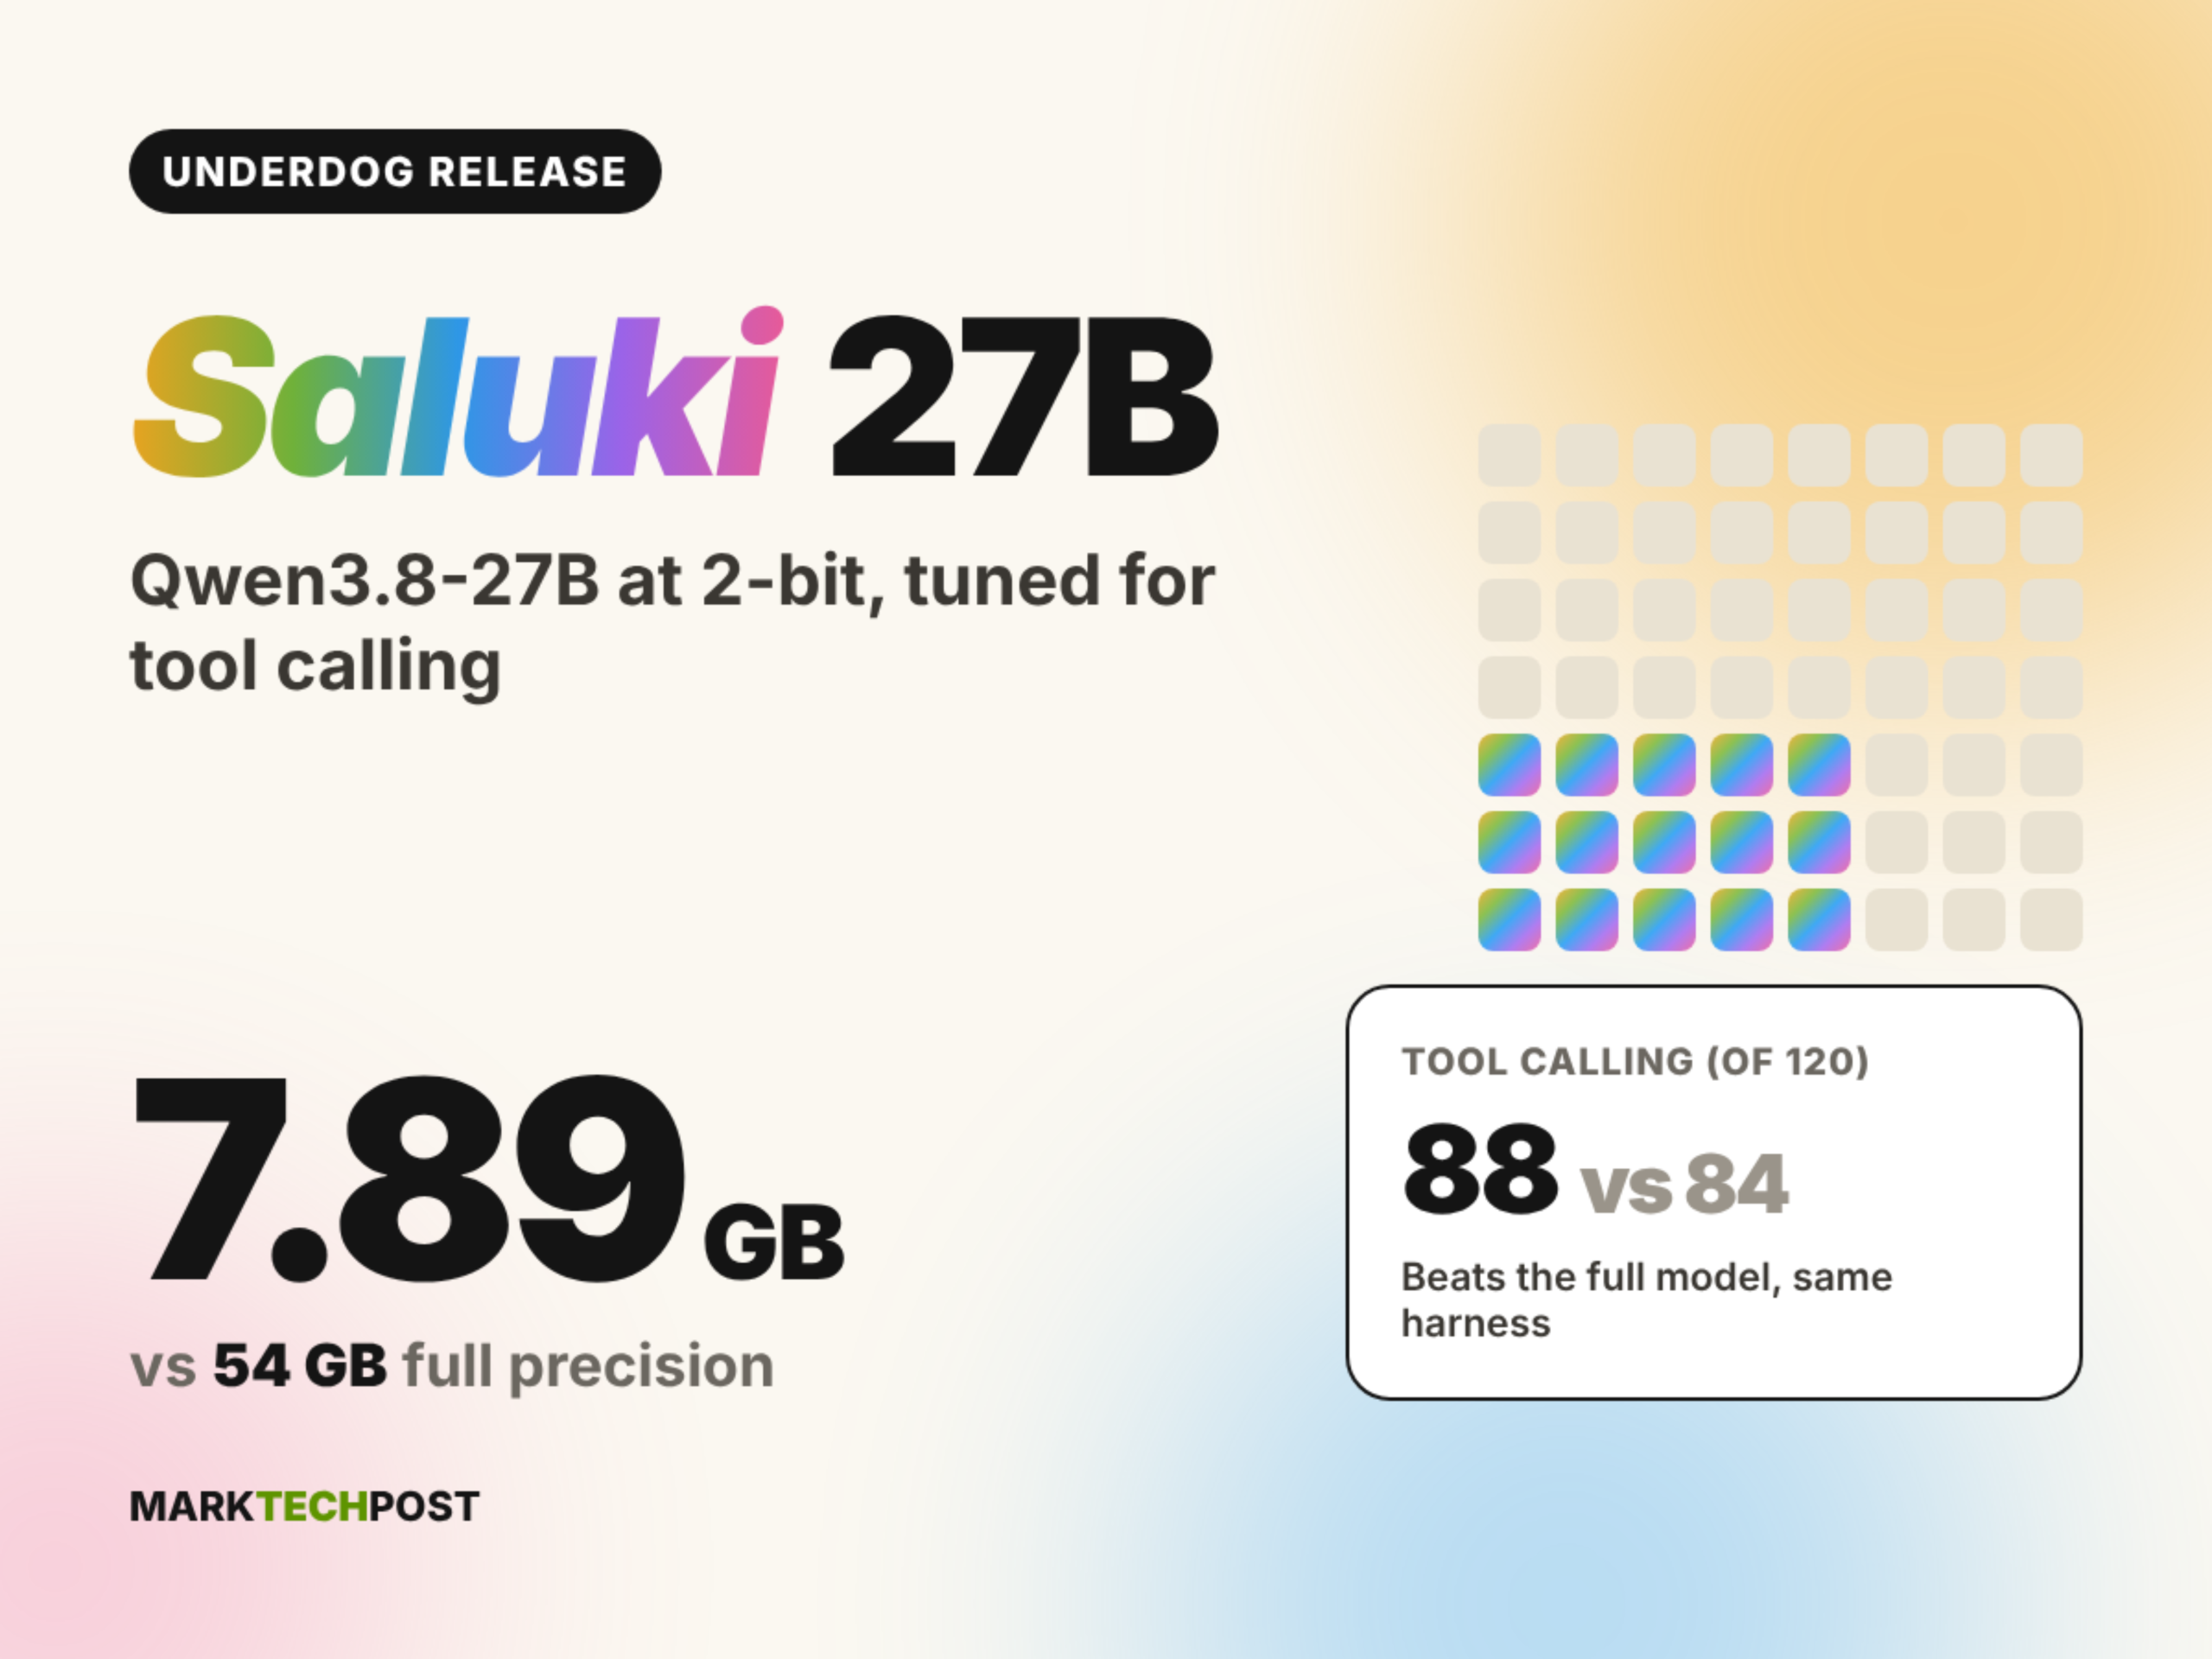
据 MarkTechPost 2026 年 10 月 9 日报道,Conway Research 旗下的端侧助手项目 Underdog 以 Apache 2.0 许可发布了 Saluki 27B。该模型是 Qwen3.8-27B 的 2-bit 混合精度 GGUF 版本,文件 7.89GB,而完整 BF16 模型为 54GB。报道称其构建叠加了三层工作:底座为 Qwen 团队 27B 密集模型 Qwen3.8-27B(64 层,混合 Gated DeltaNet 线性注意力与门控注意力,原生 262,144 tokens);其上为 ISTA-DASLab 的 GSQ-RCO GGUF,最小文件 IQ2_XS 为 8.4GB、平均 2.50 比特每权重;Underdog 再做自己的压缩与工具调用优化,产出名为 IQ2-mix、带 imatrix 标记的文件,但报道指出 Underdog 尚未公布这一步的完整配方。运行层面,报道称该模型可在原版 llama.cpp 及基于它的应用中直接运行并支持完整 GPU offload,另有 629MB 或 928MB 的可选视觉附加模块。基准方面,报道给出 Underdog 自述的两组结果:在与完整模型同框架对比的一组中,Underdog Bench(BFCL v4 的 120 个任务,关闭思考模式、temperature 为 0)Saluki 得 88 分、完整模型 84 分;并行工具调用 42 对 35;SWE-bench Verified 50 个 issue 中修复 30 个对 33 个。与公开全尺寸分数的对比中,IFEval 93.5 对 91.5、IFBench 72.7 对 71.0、MBPP+ 78.0 对 83.9、MuSR 67.5 对 79.6、AIME 2025 79.2 对 96.7、AIME 2026 80.0 对 94.6。报道同时列出 ISTA GSQ-RCO IQ2_XS 与 PrismML Bonsai 2 27B 作为对照,并强调各家厂商使用各自测试框架,跨厂商分数不可直接比较;Bonsai 2 体积更小但需 PrismML 的 llama.cpp 分支。
对开发者的影响
对需要本地智能体的开发者来说,这条消息的实质变化是:一个 27B 级别的工具调用模型,其权重量化到不足 8GB,且不需要第三方 llama.cpp 分支即可加载。这直接改变显存与部署门槛的判断——单卡消费级 GPU 甚至大内存机器的完整 offload 变得现实,也使「本地 agent 循环 + 远端模型兜底」的混合架构在成本上更可算。但必须区分开放权重与许可权利:报道称该文件以 Apache 2.0 发布,这属于许可层面的声明,可商用与否仍应回到模型卡与许可原文核对,权重可下载本身不等于许可授权范围。更需要注意能力分布并不均匀:报道称工具调用与指令遵循类指标接近或略高于原版,而 AIME、MuSR 等数学与多步推理指标下降 12 至 18 分。这意味着该量化版本适合工具编排、函数选择、格式约束类负载,不适合把它当作推理主力。另外所有分数来自 Underdog 或其引用的厂商自测,且不同厂商测试框架不同,属于被转述的声明而非独立复现,跨模型排名应视为不可比。报道未公布每权重比特数、上下文长度与压缩配方,这些未知项会影响长上下文与批量并发下的实际表现。
接入与评估建议
建议一(工具调用路由):是否把 Saluki 27B 用作本地 agent 的函数选择与参数生成层,取决于你的负载是否以并行工具调用和结构化输出为主。若你的场景是单轮或少量并行调用、对响应格式严格,报道称其并行工具调用与指令遵循类指标接近或超过原版,可优先在本地跑;若你的负载依赖长链路多步规划,报道称 MuSR 与 AIME 明显下降,则应保留原版或更强模型兜底。可测量的评估标准:在你自己的工具 schema 上跑同一批冻结任务,比较 Saluki 与原版(或现有线上模型)的工具名选择准确率与参数 JSON 合法率,以及并行调用场景下的任务完成率。建议二(压缩方案选型):在同为 2-bit 区间的候选之间选择,取决于你是否愿意维护非原版运行时。报道称 Saluki 可在原版 llama.cpp 运行,而 PrismML Bonsai 2 需要其 llama.cpp 分支,这直接影响构建、升级与 CI 复杂度;同时报道称 Saluki 未公开每权重比特与上下文,而对照方案公开了 2.50 比特每权重与文件体积。若你的团队不希望在推理框架上分叉,可把「原版 llama.cpp 可加载」作为硬性前提,再比较体积与精度;若体积是首要约束,则需接受分支维护成本。可测量的评估标准:在同一台目标机器上记录首 token 延迟、显存峰值与长上下文(接近你实际最大输入长度)下的稳定性,并核对加载该文件所需的 llama.cpp 版本要求。建议三(量化后验收):无论选择哪一方,把「量化后是否还能完成端到端任务」而非基准分数作为上线门槛。可测量的评估标准:用你线上真实流量的抽样,比较修复类任务的通过数、工具调用轮次与失败重试率,并设置一个明确的回退阈值,例如当端到端任务通过率低于原版的某个可接受比例时自动回退。以上为条件性分析与建议,不是报道中的事实陈述。
限制与待确认事项
首先需要明确:报道中的 Saluki 27B(Qwen3.8-27B 的 2-bit GGUF 派生版本)当前未出现在 KimiSeek 的模型目录中;该报道所述的分发方式是在 Hugging Face 等渠道获取 GGUF 权重并在原版 llama.cpp 本地运行,不涉及 KimiSeek 平台上的 API 可用性,任何关于 API 可用性的说法均指发布方自身渠道。其次,文中所有基准数字均转述自 Underdog 自测及其引用的公开分数,属于发布方声明,本文未做独立复现;报道本身也提示各厂商使用各自测试框架、跨厂商分数不可直接比较。第三,报道未公布该文件的每权重比特数、上下文长度与第三层压缩的完整配方,因此长上下文、批处理并发与不同硬件下的表现仍属未知。第四,权重以 Apache 2.0 发布是报道中的许可声明,是否满足具体商用条件需以模型卡与许可原文为准,权重可获取不等于授权范围明确。最后,Qwen3.8-27B 的底座能力表述(64 层、混合注意力、262,144 原生上下文)同样来自该报道,未经本文核验。