鹈鹕测试要求模型做什么?
生成一个自包含的单文件 HTML,画出骑自行车的鹈鹕;全部样式、SVG 和图片都内联在这一个文件里。
下列模型全部来自同一份实时榜单查询,统一展示公开运行数、评分人数与登录访客评分的平均值。顺序是固定的对照顺序,不是排名。
| 模型 | 公开运行 | 评分人数 | 平均星级 |
|---|---|---|---|
qwen4-max | 1 | 0 | 未评级 |
claude-opus-5 | 1 | 1 | 5.0 / 5 |
gpt-6-astra | 1 | 1 | 5.0 / 5 |
qwen3.8-max | 1 | 1 | 4.0 / 5 |
glm-5.3 | 1 | 1 | 4.0 / 5 |
实时查询:尚无评分(averageStars: null),因此是未评级,不是零星。
真实零星会显示为 0.0 / 5;未评级只表示还没有人给这个模型评分。
截取自公开隔离预览地址的真实位图。本页没有注入生成的 HTML,预览的 CSP 与沙箱均未放宽。
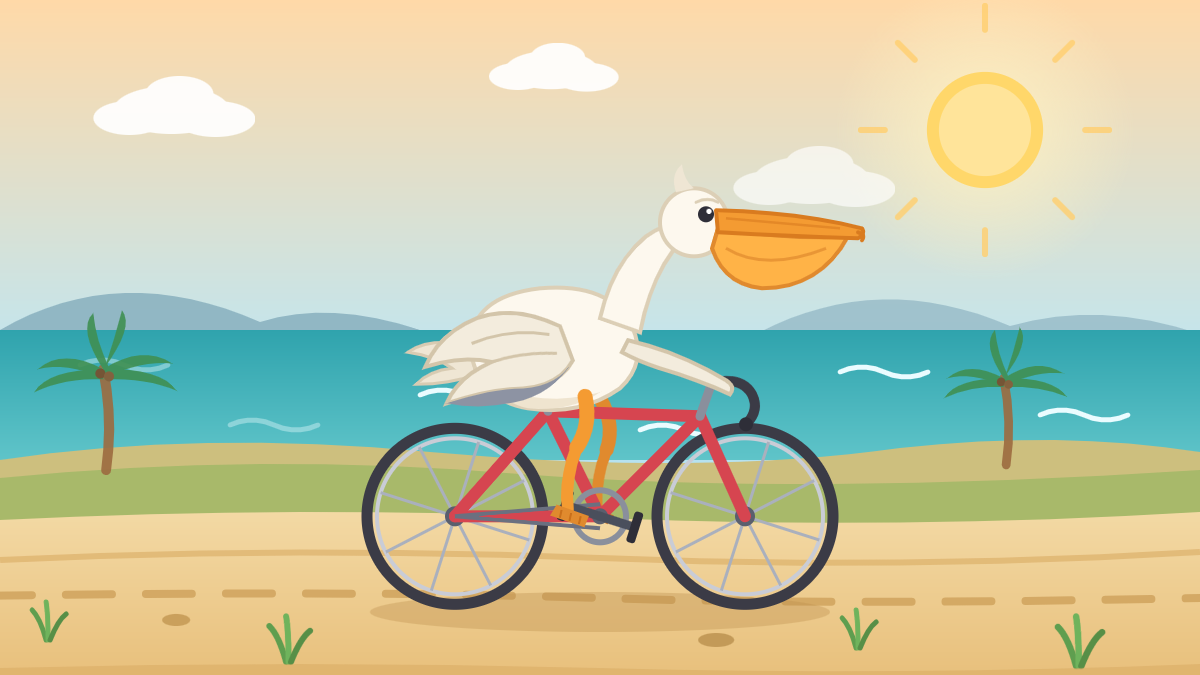
共同题目是生成一个自包含的单文件 HTML,画出骑自行车的鹈鹕。平均星级只来自登录访客的投票。
生成一个自包含的单文件 HTML,画出骑自行车的鹈鹕;全部样式、SVG 和图片都内联在这一个文件里。
只有登录访客可以评分,按主观印象打 0–5 星;每个账号对每个模型只能投一次,0 星是有效的负分票。
不能。它是登录访客主观评分的平均,不按思考强度或其他服务商的努力设置归一化,也不是模型能力分。
没有。页面只按固定对照顺序并列展示 qwen4-max 与四个参照模型的相同字段,不计算、不显示也不暗示名次。
不是。查询返回 null 表示还没有评分,即未评级;只有真实存在的 0 星投票才会显示 0.0 / 5。
页面与公开星级榜使用同一份服务端榜单查询,本页只按模型键选取五个模型;缺条目或查询失败时显示数据不可用,不回填固定数字。
使用自己的 API Key 运行鹈鹕测试,API 供应商可能按用量计费。评分是登录访客的主观意见,每个账号每个模型一票。
实时数字来自公开榜单查询;截图是指定历史运行的真实快照,不是实时 iframe。